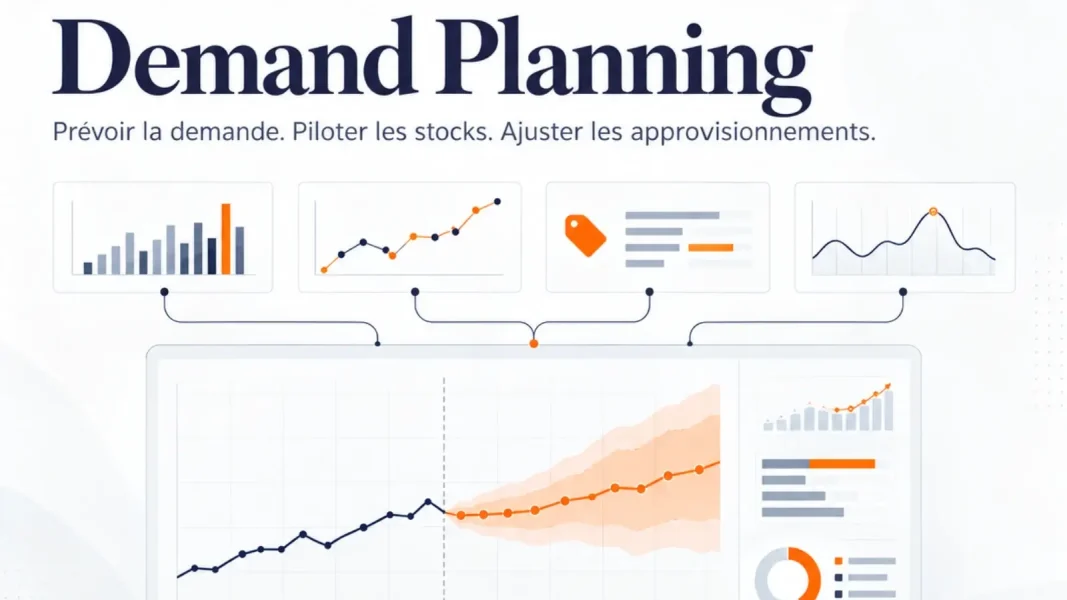
La qualité d’une prévision dépend en grande partie de la fiabilité des données sur lesquelles elle repose. Mais encore faut-il savoir mesurer cette fiabilité.
Évaluer la précision des prévisions de la demande est en effet moins simple qu’il n’y paraît.
Faut-il mesurer l’écart en unités, en pourcentage ou par rapport à une prévision de référence ? À quel horizon faut-il effectuer la comparaison ? Et comment interpréter les résultats lorsque certains produits se vendent quotidiennement tandis que d’autres enregistrent régulièrement des périodes sans aucune vente ?
Une erreur moyenne faible peut également masquer un biais persistant. À l’inverse, une prévision statistiquement moins précise peut parfois conduire à de meilleures décisions si elle permet de mieux anticiper l’incertitude et les risques associés.
Mesurer la précision des prévisions suppose donc de choisir les bons indicateurs, mais aussi de les analyser au bon niveau de granularité, au bon horizon et en fonction du profil de demande de chaque produit.
Cette mesure constitue surtout le point de départ d’une démarche d’amélioration continue du Demand Planning. Elle permet d’identifier si les écarts proviennent des données, du modèle, d’un événement non pris en compte ou encore d’un ajustement humain, puis d’agir sur le bon levier.
La précision des prévisions devient ainsi un indicateur essentiel pour fiabiliser le Demand Planning et mieux orienter les décisions de planification et d’approvisionnement.
Voyons comment mesurer correctement la précision des prévisions et améliorer durablement leur performance.
Demand planning : comment mesurer et améliorer la précision des prévisions ?
Mesurer la précision des prévisions permet d’identifier les écarts entre la demande anticipée et la demande réellement observée. Cette analyse doit toutefois tenir compte des principaux facteurs influençant la qualité des prévisions, comme la fiabilité des données, la saisonnalité, les promotions, les ruptures de stock, les variations de prix ou encore les événements exceptionnels. En Demand Planning, comprendre ces facteurs permet de mieux interpréter les erreurs de prévision et d’agir sur les leviers les plus pertinents pour améliorer leur précision.
Alors, comment mesurer et améliorer la précision des prévisions ?
1. Définir ce que l’on mesure avant d’évaluer la précision
Avant de mesurer la précision d’une prévision, il faut d’abord définir clairement ce que l’on cherche à prévoir : commandes, ventes, sorties d’entrepôt ou demande réelle.
Cette distinction est essentielle, car les ventes observées ne reflètent pas toujours la demande. En cas de rupture, par exemple, un faible niveau de ventes peut simplement traduire un manque de disponibilité.
Le même biais peut apparaître lors de commandes exceptionnelles, de décalages de livraison ou de variations inhabituelles de stock.
Dans une démarche de demand planning, il faut donc préciser la donnée prévue, le niveau de détail, le périmètre, la fréquence et l’horizon de prévision.
Une mesure de précision n’est pertinente que si elle porte sur la bonne variable, au bon niveau et au bon moment.
2. Fiabiliser les données utilisées pour mesurer l’erreur
La qualité des données influence naturellement la qualité des prévisions. Mais elle influence également la manière dont leur performance est mesurée.
Une prévision cohérente peut apparaître mauvaise si le réalisé auquel elle est comparée contient des anomalies. À l’inverse, certaines erreurs dans les données peuvent artificiellement améliorer un indicateur.
Avant d’évaluer la performance, il faut donc identifier les événements susceptibles de modifier le signal observé : ruptures et disponibilités partielles, promotions, retours, annulations, erreurs de saisie, changements de références, fermetures exceptionnelles ou encore transferts entre magasins et canaux.
L’objectif n’est pas pour autant d’effacer systématiquement les valeurs atypiques.
Un pic de ventes peut provenir d’une erreur de saisie, mais également d’une promotion particulièrement performante ou d’un événement local. Dans le premier cas, la donnée doit être corrigée. Dans le second, elle constitue une information réelle qu’il faut conserver et expliquer.
Les corrections doivent également rester traçables. Conserver la donnée brute, la donnée corrigée et le motif de la modification permet d’auditer le processus et d’éviter qu’un nettoyage excessif ne produise artificiellement de meilleures performances.
Pour mesurer correctement la précision des prévisions, le principe essentiel reste donc simple : la prévision et le réalisé doivent être comparables et représenter la même réalité métier.

3. Tenir compte de la prévisibilité des produits
Tous les produits ne sont pas également prévisibles.
Une référence vendue quotidiennement en quantité importante fournit un signal beaucoup plus riche qu’une pièce de rechange commandée quelques fois par an. De même, un produit mature et stable ne présente pas les mêmes caractéristiques qu’une nouveauté, un produit fortement saisonnier ou un article dont les ventes sont très volatiles.
La difficulté de prévision dépend notamment :
- du volume et de la fréquence des ventes ;
- de la variabilité de la demande ;
- de son caractère régulier ou intermittent ;
- de la présence d’une tendance ou d’une saisonnalité ;
- du cycle de vie du produit ;
- de sa sensibilité aux prix et aux promotions ;
- de la fréquence des événements exceptionnels ;
- des possibilités de substitution avec d’autres références.
Comparer directement la précision de produits présentant des profils très différents peut donc conduire à des conclusions trompeuses.
Une segmentation de type volume-variabilité, proche d’une logique ABC-XYZ, permet par exemple de distinguer les références à fort impact économique des produits dont la demande est particulièrement erratique. D’autres dimensions peuvent compléter cette segmentation : marge, criticité, cycle de vie, délai fournisseur ou substituabilité.
Cette classification permet ensuite d’adapter les modèles, les indicateurs et le niveau d’intervention humaine.
Les références stables et volumineuses peuvent être largement automatisées. Les demandes intermittentes nécessitent des méthodes et des métriques adaptées aux périodes sans vente. Les références à fort enjeu et forte volatilité peuvent, quant à elles, justifier davantage de contrôle.
L’objectif n’est donc pas d’obtenir le même niveau de précision partout, mais d’évaluer chaque prévision au regard de la prévisibilité réelle du produit.
4. Mesurer la précision au bon niveau de granularité
Plus une prévision est agrégée, plus la demande tend généralement à être stable.
Les variations de plusieurs références, magasins ou canaux peuvent se compenser lorsqu’elles sont regroupées. Il est donc souvent plus facile de prévoir les ventes nationales d’une catégorie que celles de chaque référence dans chaque point de vente.
Mais la prévision statistiquement la plus précise n’est pas nécessairement la plus utile.
Une prévision nationale peut être excellente tout en étant insuffisante pour déterminer combien d’unités doivent être envoyées dans chaque entrepôt. À l’inverse, mesurer uniquement la performance au niveau article-magasin peut donner une vision excessivement négative si de nombreuses séries présentent de faibles volumes ou une demande intermittente.
Le niveau d’évaluation doit donc concilier trois contraintes :
- disposer d’un historique suffisamment riche ;
- correspondre au niveau auquel les décisions sont réellement prises ;
- maintenir une cohérence entre les différents niveaux de prévision.
La performance peut ainsi être suivie simultanément par référence, catégorie, magasin, région ou canal.
Cette lecture hiérarchique permet notamment d’identifier une situation fréquente : une prévision globalement correcte peut masquer d’importantes erreurs d’allocation. L’entreprise prévoit alors le bon volume total, mais pas nécessairement au bon endroit.
Les méthodes de réconciliation hiérarchique peuvent alors contribuer à maintenir la cohérence entre les différents niveaux du demand planning.
5. Mesurer la précision à chaque horizon de décision
Une prévision n’a pas une précision unique.
Son niveau d’incertitude évolue avec l’horizon. Prévoir la demande de la semaine prochaine et celle des trois prochains mois sont deux exercices différents.
À court terme, davantage d’informations sont déjà connues : commandes récentes, disponibilité, opérations commerciales confirmées ou signaux de vente récents. À mesure que l’horizon s’éloigne, davantage de facteurs deviennent incertains.
Il faut donc considérer la précision comme une performance qui évolue selon l’horizon, plutôt que comme un chiffre unique.
Surtout, la mesure doit correspondre au moment où l’entreprise devait réellement prendre sa décision.
Imaginons qu’un fournisseur exige une commande trois mois à l’avance. Évaluer uniquement la prévision révisée quinze jours avant la vente ne permet pas de savoir si l’information disponible au moment de l’engagement fournisseur était suffisamment fiable.
Une pratique plus robuste consiste à conserver différentes versions de la prévision puis à mesurer, par exemple :
- la prévision disponible à J-7 ;
- la prévision disponible à J-30 ;
- la prévision disponible à J-90.
Chacune peut ensuite être comparée au réalisé.
Cette approche évite de mesurer après coup une prévision actualisée avec des informations qui n’étaient pas disponibles lorsque la décision opérationnelle devait être prise.
La bonne question n’est donc pas seulement « Quelle était notre erreur ? », mais également « Quelle était notre erreur au moment où nous devions décider ? »

6. Quels indicateurs utiliser pour mesurer la précision des prévisions ?
Il n’existe pas un indicateur universel capable de résumer à lui seul la qualité d’une prévision.
Chaque métrique met en évidence une dimension différente de l’erreur. Le choix doit dépendre du profil de demande, du niveau d’analyse et de l’usage opérationnel.
MAE : mesurer l’erreur moyenne en unités
La MAE, ou Mean Absolute Error, mesure la moyenne des écarts absolus entre la prévision et le réalisé.
Elle présente un avantage majeur : le résultat reste exprimé dans l’unité du produit.
Une MAE de 50 signifie ainsi que la prévision s’écarte en moyenne de 50 unités du réalisé.
Cette métrique est simple à interpréter, mais elle permet difficilement de comparer des références dont les volumes sont très différents. Une erreur de 50 unités peut être négligeable pour un produit vendu à plusieurs milliers d’exemplaires et considérable pour un produit dont les ventes habituelles sont de 70 unités.
RMSE : donner davantage de poids aux erreurs importantes
La RMSE, ou Root Mean Squared Error, accorde davantage de poids aux écarts importants.
Elle peut être particulièrement utile lorsque les grosses erreurs présentent un coût opérationnel disproportionné.
En revanche, cette sensibilité signifie également que quelques événements extrêmes peuvent fortement influencer le résultat.
MAE et RMSE ne répondent donc pas exactement à la même question. La première mesure une erreur moyenne facilement interprétable ; la seconde attire davantage l’attention sur les erreurs de grande amplitude.
MAPE : exprimer l’erreur en pourcentage
Le MAPE, ou Mean Absolute Percentage Error, rapporte l’erreur au volume réellement observé.
Son expression en pourcentage le rend intuitif et explique en grande partie sa popularité.
Mais il présente une limite importante : lorsque les ventes réelles deviennent très faibles, le pourcentage d’erreur peut devenir extrêmement élevé. Lorsque le réalisé est nul, le calcul devient problématique.
Le MAPE est donc mal adapté aux références caractérisées par une demande faible ou intermittente.
MASE : comparer les performances entre différentes séries
La MASE, ou Mean Absolute Scaled Error, rapporte l’erreur du modèle à celle d’une prévision de référence.
Cette normalisation facilite les comparaisons entre séries de tailles différentes et permet surtout de répondre à une question essentielle :
le modèle fait-il réellement mieux qu’une méthode simple ?
C’est un point important dans l’évaluation d’un processus de demand planning. Une méthode sophistiquée peut sembler performante en valeur absolue sans apporter de véritable amélioration par rapport à une prévision naïve.
Le biais : détecter les sous-prévisions et les sur-prévisions persistantes
L’erreur moyenne ne suffit pas.
Une prévision peut présenter une précision apparemment satisfaisante tout en surestimant ou sous-estimant systématiquement la demande.
C’est ce que permet d’identifier le biais de prévision.
Cette information est essentielle car les conséquences opérationnelles sont différentes. Une sous-prévision persistante augmente le risque de rupture. Une sur-prévision répétée peut entraîner davantage de stock, d’immobilisation financière ou de démarque.
Les erreurs positives et négatives pouvant se compenser dans certaines mesures agrégées, le biais doit être suivi séparément.
Mesurer également l’incertitude
Une prévision ponctuelle de 1 000 unités donne l’impression qu’un seul futur est envisagé.
Or deux produits présentant la même prévision moyenne peuvent avoir des niveaux d’incertitude très différents.
Associer la prévision à un intervalle de prédiction permet d’estimer une plage plausible de demande. Cette information devient particulièrement utile pour dimensionner les stocks de sécurité, construire plusieurs scénarios et arbitrer entre risque de rupture et risque de surplus.
Un dispositif robuste ne repose donc pas sur un seul pourcentage de précision. Il combine généralement plusieurs dimensions : erreur, biais, performance relative à une référence, évolution selon l’horizon et niveau d’incertitude.
7. Comparer les modèles à une prévision de référence
Un modèle complexe n’est pas nécessairement un meilleur modèle.
Une moyenne mobile, une méthode naïve saisonnière ou un modèle statistique relativement simple peuvent produire de bons résultats lorsque la demande présente une structure adaptée.
Avant de rechercher davantage de sophistication, il est donc utile de construire une baseline, c’est-à-dire une prévision de référence suffisamment simple pour servir de point de comparaison.
Elle peut par exemple consister à utiliser :
- la dernière valeur observée ;
- la moyenne des dernières périodes ;
- les ventes de la même période de l’année précédente ;
- une prévision saisonnière simple.
Le modèle candidat doit ensuite démontrer qu’il apporte une amélioration par rapport à cette référence.
Mais cette comparaison ne doit pas être réalisée uniquement sur les données ayant servi à construire le modèle.
Un modèle très flexible peut reproduire remarquablement l’historique tout en se révélant médiocre sur de nouvelles périodes. C’est le phénomène de surapprentissage.
Pour reproduire plus fidèlement les conditions réelles du demand planning, la validation peut être effectuée à plusieurs moments de l’historique.
Le modèle apprend d’abord sur les données disponibles jusqu’à une date donnée, produit une prévision aux horizons souhaités, puis l’exercice est répété en avançant dans le temps.
Ce backtesting permet de comparer les méthodes sur différentes périodes, différents régimes de demande et surtout aux horizons réellement utilisés par les équipes.
Le machine learning peut apporter de la valeur lorsque l’entreprise dispose de nombreuses séries, d’un historique suffisamment riche et de variables explicatives pertinentes. Mais sa performance doit être démontrée dans les mêmes conditions que celle des modèles plus simples.
L’objectif n’est pas de sélectionner la technologie la plus sophistiquée, mais le modèle qui améliore réellement les prévisions sur des données qu’il n’a jamais vues.
8. Identifier l’origine des erreurs de prévision
Mesurer une erreur n’est que la première étape. Pour améliorer les prévisions, il faut ensuite comprendre l’origine des écarts.
Une dégradation de la performance peut provenir de plusieurs sources :
- une donnée incorrecte ou incomplète ;
- une rupture ayant masqué une partie de la demande ;
- un changement de comportement ;
- une promotion ou un changement de prix mal renseigné ;
- un événement exceptionnel absent du modèle ;
- une rupture de tendance ou de saisonnalité ;
- un modèle devenu moins adapté ;
- une modification humaine inappropriée.
Toutes ces erreurs n’appellent pas la même réponse.
Changer de modèle ne résoudra pas un problème provenant d’une donnée de stock incorrecte. Ajouter davantage d’historique ne corrigera pas nécessairement une rupture structurelle récente. Et multiplier les variables externes n’améliorera pas automatiquement les résultats si celles-ci ne sont pas suffisamment fiables ou disponibles au moment où la prévision doit être produite.
L’analyse des erreurs doit donc précéder le choix de la solution.
Il est particulièrement utile de segmenter les écarts par produit, catégorie, site, canal et horizon afin d’identifier les zones dans lesquelles la performance se dégrade réellement.
Cette logique permet de passer d’un constat général — « nos prévisions manquent de précision » — à un diagnostic exploitable : où perdons-nous en précision, depuis quand, à quel horizon et pour quel type de demande ?

9. Mesurer la valeur ajoutée des ajustements humains
Un modèle ne dispose pas nécessairement de toutes les informations connues par les équipes.
Un commercial peut connaître l’arrivée prochaine d’un nouveau client. Le marketing peut avoir validé une campagne qui n’existe pas encore dans les données. Les achats peuvent connaître une modification prochaine de l’assortiment.
L’intervention humaine peut donc améliorer la prévision.
Mais elle peut également la dégrader.
Augmenter une prévision parce qu’elle « paraît trop basse », multiplier les corrections non documentées ou confondre prévision et objectif commercial peut introduire progressivement du biais dans le processus.
La question n’est donc pas de choisir entre automatisation et expertise humaine, mais de mesurer la valeur réellement apportée par chaque intervention.
C’est notamment l’objectif de la Forecast Value Added, ou FVA.
L’entreprise peut comparer successivement les performances d’une prévision naïve, du modèle statistique, de la prévision après ajustement du demand planner puis, le cas échéant, du consensus commercial.
À chaque étape, elle mesure si l’intervention améliore ou dégrade effectivement la prévision.
Si une étape détériore régulièrement les résultats, son fonctionnement doit être réévalué, même si elle fait historiquement partie du processus.
Les ajustements gagnent également à être documentés : auteur, date, motif, valeur initiale, nouvelle valeur et durée de validité.
Cette traçabilité transforme l’intervention humaine en processus mesurable et permet aux équipes de concentrer leur expertise sur les situations où elle apporte réellement de la valeur : lancements, événements exceptionnels, références prioritaires ou changements structurels.
10. Relier la précision des prévisions aux résultats opérationnels
Une amélioration statistique n’a d’intérêt que si elle contribue à de meilleures décisions.
Prévoir une demande de 1 000 unités au cours des quatre prochaines semaines ne signifie pas nécessairement qu’il faut commander immédiatement 1 000 unités.
La décision dépend également du stock disponible, des commandes déjà engagées, des ventes attendues avant la prochaine livraison, du délai fournisseur, des minimums de commande, des capacités logistiques et du niveau de service recherché.
Il faut donc distinguer trois dimensions.
La qualité du signal de demande : la prévision représente-t-elle correctement la demande attendue et son incertitude ?
La politique de stock : les paramètres de réapprovisionnement, les stocks de sécurité, les fréquences de commande et les niveaux de service sont-ils cohérents avec cette incertitude ?
L’exécution logistique : les commandes et les livraisons sont-elles effectivement réalisées dans les conditions prévues ?
Cette distinction est fondamentale.
Une rupture peut être provoquée par une sous-prévision, mais également par une commande passée trop tard ou une livraison fournisseur en retard.
De même, un surstock ne prouve pas nécessairement que la prévision était trop élevée : il peut résulter d’un minimum de commande, d’une modification d’assortiment ou d’une règle de stock devenue obsolète.
La précision des prévisions doit donc être mise en perspective avec les KPI opérationnels : taux de service, ruptures, disponibilité, niveaux de stock, démarque ou encore coûts associés.
L’objectif du demand planning n’est pas d’obtenir le meilleur score statistique possible. Il est de produire une information suffisamment fiable pour améliorer les décisions opérationnelles.
11. Construire une démarche d’amélioration continue de la précision
Améliorer durablement la précision des prévisions ne consiste pas nécessairement à remplacer immédiatement le modèle ou à ajouter davantage de complexité.
Une démarche structurée commence par identifier précisément où la performance peut être améliorée.
Définir précisément la cible
Il faut d’abord déterminer ce qui est prévu, à quel niveau de granularité, à quelle fréquence et pour alimenter quelle décision.
Établir une baseline
Les modèles existants doivent être comparés à une méthode simple et reproductible afin de mesurer leur véritable valeur ajoutée.
Segmenter les profils de demande
Les références stables, saisonnières, intermittentes, nouvelles ou fortement volatiles ne doivent pas nécessairement être évaluées et traitées de la même manière.
Mesurer aux horizons réellement utilisés
Les prévisions doivent être évaluées dans la version disponible au moment où les décisions sont prises, et non uniquement dans leur dernière version avant le réalisé.
Combiner plusieurs indicateurs
L’erreur doit être complétée par l’analyse du biais, de la performance par rapport à une baseline et, lorsque cela est pertinent, de l’incertitude associée à la prévision.
Tester les modèles sur des périodes non utilisées pour l’apprentissage
Un backtesting représentatif des conditions réelles permet d’éviter de sélectionner des modèles performants uniquement sur les données historiques qui ont servi à leur construction.
Analyser les causes des écarts
Les erreurs doivent être attribuées autant que possible à leur origine : données, modèle, événement non anticipé, changement structurel ou ajustement humain.
Mesurer la Forecast Value Added
Chaque étape du processus, automatique comme humaine, doit pouvoir démontrer qu’elle contribue effectivement à améliorer la qualité de la prévision.
Relier la précision aux résultats opérationnels
Une meilleure prévision doit être mise en perspective avec les objectifs opérationnels : disponibilité, niveau de service, maîtrise des stocks et capacité à anticiper les besoins.
Surveiller la performance dans le temps
Un modèle performant aujourd’hui ne le restera pas nécessairement.
Les assortiments évoluent, les comportements changent et les relations apprises à partir de l’historique peuvent progressivement perdre leur pertinence.
Le suivi du biais, de la dérive des données, de la baisse de performance ou de la multiplication des ajustements permet de détecter ces changements et de réévaluer les modèles avant que les écarts ne deviennent structurels.
Faire de la précision un véritable outil de pilotage du demand planning
Mesurer la précision des prévisions ne consiste pas à rechercher un pourcentage unique censé résumer toute la performance du demand planning.
Une évaluation pertinente doit tenir compte de ce qui est réellement prévu, du profil de demande, du niveau de granularité et surtout de l’horizon auquel la décision doit être prise.
Elle doit également combiner plusieurs lectures. L’erreur mesure l’ampleur des écarts. Le biais révèle les tendances persistantes à sur-prévoir ou sous-prévoir. La comparaison avec une baseline indique si le modèle apporte réellement de la valeur. Les intervalles de prédiction permettent, quant à eux, de rendre visible l’incertitude que la prévision ponctuelle ne montre pas.
Mais la mesure n’est utile que si elle débouche sur une action.
En identifiant précisément où, quand et pourquoi les prévisions se dégradent, les entreprises peuvent intervenir sur le bon levier : qualité des données, segmentation, choix du modèle, variables explicatives, ajustements humains ou processus opérationnels.
L’enjeu n’est donc pas de faire disparaître toute incertitude. Une partie de la demande restera toujours difficile à anticiper.
L’objectif consiste plutôt à réduire les erreurs évitables, à quantifier l’incertitude restante et à l’intégrer aux décisions de stock et d’approvisionnement.
Une prévision performante n’est finalement pas celle qui prétend avoir toujours raison. C’est celle dont l’entreprise connaît suffisamment la fiabilité pour savoir où sécuriser du stock, où limiter l’engagement, quand réagir et sur quelles références concentrer l’attention des équipes.
C’est cette capacité à mesurer, comprendre et exploiter la qualité des prévisions qui transforme le demand planning en véritable outil d’aide à la décision.