Pour prévoir la demande, il faut d’abord comprendre ce qui a été vendu par le passé. Mais l’historique des ventes ne peut pas être interprété tel quel. Les volumes enregistrés dépendent de nombreux facteurs : la demande des clients, la disponibilité des produits, leur prix, les promotions ou encore le canal de distribution. Lorsqu’un article est en rupture, les ventes chutent sans que la demande ait nécessairement diminué. À l’inverse, une promotion peut provoquer un pic ponctuel qui ne se reproduira pas.
L’historique des ventes ne constitue donc pas une prévision. Il représente la matière première à partir de laquelle les tendances, les cycles et les événements passés peuvent être analysés. Sa valeur dépend moins du volume de données accumulé que de la capacité à expliquer ce que chaque observation représente.
Pour les retailers qui gèrent des milliers de références, cette distinction a des conséquences directes sur le demand planning, les approvisionnements et les stocks. Une mauvaise interprétation des données peut entraîner des commandes excessives, des ruptures, des transferts inutiles ou une augmentation des démarques.
Dans cet article, nous verrons comment structurer, nettoyer et analyser l’historique des ventes pour fiabiliser la prévision de la demande et mieux orienter les décisions.
Qu’est-ce qu’un historique des ventes ?
L’historique des ventes regroupe les transactions réalisées sur une période passée. Chaque ligne associe généralement une date, un produit, une quantité vendue, un point de vente ou un canal, un prix et un montant de chiffre d’affaires. Selon le système d’information, d’autres attributs peuvent être disponibles : remise, promotion, retour, annulation, stock au moment de la vente, identité du fournisseur, délai de livraison ou caractéristiques du client.
Les données de caisse mesurent des sorties magasin, tandis que les commandes e-commerce peuvent être enregistrées à la validation, à l’expédition ou à la livraison. Une analyse pertinente commence donc par la définition exacte de l’événement mesuré.
La granularité compte tout autant. Un total mensuel de ventes peut convenir à un exercice budgétaire, mais masquer les pics hebdomadaires utiles aux approvisionnements. Une série quotidienne révèle davantage de variations, au prix d’un bruit plus important. Enfin, un historique consolidé par catégorie ne permet pas de prévoir chaque produit et chaque emplacement. La donnée doit être disponible au niveau auquel la décision sera prise, ou à un niveau permettant une désagrégation maîtrisée.
Historique des ventes et données historiques : quelle différence ?
Les données historiques ne se limitent pas aux ventes. Elles peuvent aussi inclure les niveaux de stock, les ruptures, les commandes non servies, les prix, les promotions, les retours, les délais fournisseurs, la fréquentation, le calendrier ou encore la météo. L’historique des ventes montre ce qui a été acheté, tandis que les données associées permettent d’expliquer les variations observées.
Elles aident notamment à distinguer une baisse réelle de la demande d’un recul provoqué par une rupture de stock, ou une croissance durable d’une hausse ponctuelle liée à une promotion.

Pourquoi l’historique des ventes est-il indispensable à la prévision de la demande ?
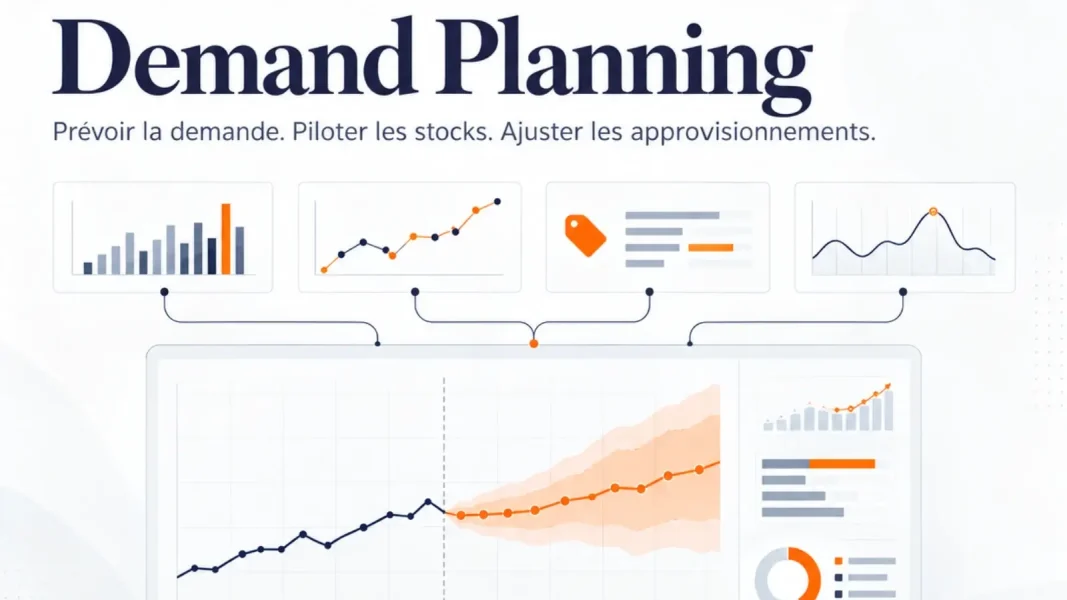
La prévision consiste à estimer les ventes futures à partir des informations disponibles. L’historique permet d’en analyser quatre composantes principales : le niveau moyen de la demande, son évolution, sa saisonnalité et les variations qui ne peuvent pas être expliquées par le modèle.
Le niveau moyen fournit un premier ordre de grandeur. La tendance indique si les ventes progressent, diminuent ou changent durablement de rythme. La saisonnalité fait ressortir les variations qui se répètent selon les jours, les semaines ou les périodes de l’année. Enfin, les variations résiduelles peuvent provenir d’aléas, d’événements ponctuels, d’erreurs dans les données ou de facteurs qui n’ont pas été pris en compte.
Le poids de chaque composante varie selon les produits. Les ventes d’un produit alimentaire peuvent suivre un rythme hebdomadaire régulier, celles d’un article de jardin dépendre fortement de la météo, tandis qu’une pièce détachée peut être vendue de façon beaucoup plus irrégulière. Appliquer la même méthode à toutes les références ne permettrait pas de tenir compte de ces différences.
L’analyse de l’historique aide donc à identifier le comportement de chaque série de ventes avant de choisir la méthode de prévision la plus adaptée. Elle permet également de regrouper les références selon leur profil, de déterminer la fréquence des mises à jour et de comparer ensuite les prévisions aux ventes réellement enregistrées.
Les ventes passées représentent-elles toujours la demande réelle ?
Non ! Les ventes correspondent à la demande satisfaite, pas nécessairement à la demande exprimée. Lorsque le produit est disponible et correctement exposé, l’écart peut être faible. Dès que l’offre contraint l’achat, l’historique sous-estime le potentiel réel.
Une rupture de stock est le cas le plus évident. Si le stock atteint zéro pendant trois jours, les ventes enregistrées sur ces trois jours ne permettent pas de mesurer ce que les clients auraient acheté. Une partie de la demande est perdue, une autre se reporte vers une référence proche, un autre magasin ou un concurrent. Réinjecter les zéros dans le modèle sans correction apprend à l’algorithme qu’une baisse de demande s’est produite, alors qu’il s’agissait d’une impossibilité de vendre.
D’autres facteurs créent le même décalage : fermeture exceptionnelle, panne du site, référencement tardif, retrait temporaire ou capacité de préparation saturée. À l’opposé, une promotion ou une mise en avant peut augmenter les ventes sans modifier durablement la demande de base.
La reconstitution de la demande consiste à corriger ou annoter ces périodes. Elle ne signifie pas remplacer arbitrairement chaque valeur atypique. Il faut identifier la cause, estimer le volume non observé avec une règle documentée et conserver la donnée brute pour assurer la traçabilité. La prévision gagne alors en fiabilité sans effacer l’histoire opérationnelle du produit.
Quelles données faut-il associer à l’historique des ventes ?
Une série de quantités et de dates suffit à construire une première prévision statistique. Elle devient toutefois limitée dès que la demande réagit fortement aux décisions commerciales ou à des facteurs externes. Les sources de données à rapprocher dépendent du secteur et du produit, mais plusieurs familles reviennent régulièrement.
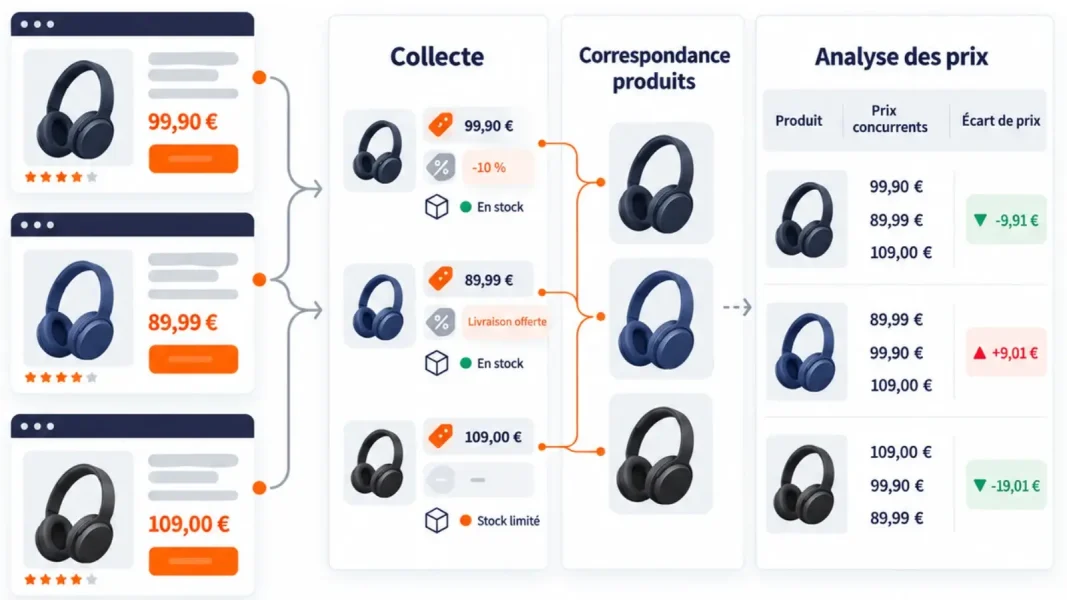
Les données produit décrivent la référence, sa catégorie, son statut et son cycle de vie. Les données commerciales couvrent le prix, les promotions et les changements d’assortiment. Les données de stock indiquent la disponibilité, les ruptures et les réceptions. Le calendrier identifie jours fériés, vacances, soldes ou événements locaux. Certaines variables exogènes, comme la météo, l’inflation ou les prix concurrents, peuvent aussi expliquer la demande.
L’objectif n’est pas de connecter toutes les bases de données disponibles. Chaque source doit améliorer l’explication ou la prévision d’un comportement. Ajouter des centaines de variables peu fiables augmente la complexité, ralentit les traitements et peut réduire la robustesse des modèles. Le bon critère reste leur pouvoir explicatif, leur disponibilité future et leur qualité dans le temps.
Une variable connue uniquement après la période à prévoir ne peut pas être utilisée directement. De même, une donnée externe très corrélée aux ventes n’apporte aucune valeur si elle n’est pas disponible avec une fréquence et un horizon compatibles avec le planning opérationnel.
Comment préparer un historique avant de l’analyser ?
La préparation concentre souvent davantage d’efforts que la modélisation. Un algorithme sophistiqué ne compense pas des références dupliquées, des dates incohérentes ou des ruptures assimilées à une demande nulle. Le processus doit préserver une version brute, produire une série corrigée et documenter chaque transformation.
Harmoniser les référentiels
Les changements de codes articles, les fusions de magasins ou les migrations d’ERP fragmentent fréquemment les séries. Lorsque les anciens et les nouveaux identifiants correspondent à une même réalité commerciale, ils doivent être rapprochés. En revanche, regrouper deux produits distincts sous prétexte que leurs libellés sont proches peut créer une continuité artificielle.
Choisir une granularité cohérente
La fréquence quotidienne convient aux produits à rotation rapide, aux événements courts et aux décisions de réapprovisionnement fréquentes. Le niveau hebdomadaire réduit le bruit et facilite l’identification des tendances. Le mois est utile pour une vision agrégée, mais souvent trop peu précis pour piloter les stocks.
Le choix dépend aussi du délai d’approvisionnement. La granularité analytique doit rester alignée avec la fréquence des décisions.
Traiter les valeurs manquantes et les doublons
Une absence d’enregistrement peut signifier zéro vente, donnée non remontée ou référence non active. Ces trois situations ne se traitent pas de la même façon. Les doublons, quant à eux, peuvent provenir d’une réintégration de fichiers ou de transactions enregistrées dans plusieurs systèmes. Les règles de correction doivent s’appuyer sur le statut du produit et la couverture réelle des sources.
Identifier les points extrêmes
Un volume inhabituel n’est pas forcément une erreur. Il peut correspondre à une commande exceptionnelle, une promotion, une ouverture de magasin ou un événement local. Supprimer automatiquement les points extrêmes prive le modèle d’informations utiles. Il est préférable de les qualifier, puis de décider s’ils appartiennent à la demande récurrente, à un effet explicable ou à une anomalie de données.
Corriger les ruptures et les périodes non comparables
La correction peut s’appuyer sur les jours voisins, les mêmes jours des semaines précédentes, des magasins comparables ou le comportement d’articles proches. Plus la rupture est longue, plus l’estimation devient incertaine. La valeur corrigée doit donc pouvoir être distinguée d’une vente réellement observée.
Les périodes non comparables comprennent aussi les confinements, travaux, changements majeurs de gamme ou migrations de canal. Plutôt que de les effacer, il peut être pertinent de réduire leur poids, de les isoler par une variable ou d’entraîner le modèle sur une fenêtre plus représentative.

Quelle profondeur d’historique faut-il conserver ?
Il n’existe pas de durée idéale applicable à tous les produits. La profondeur de l’historique dépend du cycle de vente, de la fréquence des observations et de la stabilité de la demande. Pour repérer une saisonnalité annuelle, il est préférable de disposer de plusieurs années comparables. Pour une référence commercialisée pendant seulement six mois, un historique aussi long n’est ni disponible ni forcément pertinent, même en utilisant les données d’un produit similaire.
Un historique étendu aide à identifier les cycles, mais il peut aussi contenir des comportements qui ne correspondent plus à la situation actuelle après une évolution du prix, du canal ou de l’assortiment. Une période plus courte reflète mieux les tendances récentes, mais accorde davantage de poids aux variations ponctuelles.
La question n’est donc pas seulement de savoir combien d’années conserver, mais quelles périodes peuvent réellement être comparées. Il est possible de tester plusieurs profondeurs d’historique et de retenir celle qui donne les prévisions les plus fiables. Les données les plus anciennes peuvent également recevoir un poids moins important, notamment avec le lissage exponentiel.
Comment analyser un historique des ventes ?
L’analyse commence par une visualisation simple. Une courbe chronologique par produit et par emplacement révèle souvent des ruptures de série, des pics, des changements de niveau ou des cycles invisibles dans un tableau de données. Les tableaux de bord doivent permettre de passer d’une vue consolidée à la série élémentaire sans perdre les annotations liées aux événements.
Mesurer le niveau, la dispersion et la régularité
La moyenne et la médiane donnent deux lectures complémentaires. Une différence importante entre elles signale souvent des pics ou une distribution asymétrique. L’écart-type et le coefficient de variation mesurent la dispersion relative. La fréquence des périodes sans vente aide à reconnaître une demande intermittente.
Ces indicateurs orientent aussi la segmentation et le stock de sécurité. Deux produits affichant la même vente annuelle peuvent exiger des politiques différentes si l’un se vend chaque jour et l’autre par commandes rares.
Distinguer tendance et saisonnalité
La tendance reflète l’évolution générale des ventes sur la durée, tandis que la saisonnalité correspond à des variations qui se répètent à intervalles réguliers. Il peut s’agir d’une hausse chaque samedi, d’un pic avant Noël ou d’un ralentissement pendant l’été. Les coefficients saisonniers permettent de mesurer ces variations, à condition de vérifier qu’elles se reproduisent de manière suffisamment stable d’une année à l’autre.
La décomposition des séries chronologiques permet ensuite de distinguer le niveau des ventes, la tendance, la saisonnalité et les variations résiduelles. Elle évite ainsi d’attribuer à un effet saisonnier une hausse qui relève en réalité d’une progression générale. Elle facilite également la comparaison entre plusieurs périodes en neutralisant les variations récurrentes.
Rechercher les facteurs explicatifs
La corrélation mesure l’association entre deux variables, mais ne prouve pas un lien de causalité. Une hausse simultanée des ventes et du trafic peut indiquer un effet d’acquisition ; elle peut aussi résulter d’une promotion qui influence les deux. Le prix, la remise, la disponibilité, la météo ou le calendrier doivent être analysés avec leur temporalité et leurs interactions.
Une régression peut quantifier la relation entre la demande et plusieurs facteurs. Elle devient utile lorsque les variables sont fiables, suffisamment variables et disponibles pour le futur. Les modèles de machine learning captent des relations plus complexes, mais exigent les mêmes précautions de qualité, de disponibilité et d’interprétation.
Segmenter les produits selon leur comportement
La segmentation ABC classe les références selon leur contribution aux ventes ou à la marge. Une segmentation XYZ les distingue selon leur prévisibilité ou leur variabilité. Leur combinaison évite d’investir le même effort sur une référence majeure et stable, un article marginal et erratique ou un nouveau produit.
D’autres critères peuvent compléter l’analyse : fréquence de vente, durée de vie, sensibilité promotionnelle, saisonnalité et délai fournisseur. La segmentation doit conduire à des règles différentes de prévision et de pilotage, faute de quoi elle reste descriptive.
Lorem ipsum dolor sit amet, consectetur adipiscing elit. Ut elit tellus, luctus nec ullamcorper mattis, pulvinar dapibus leo.
Quelles méthodes de prévision utiliser à partir des ventes passées ?
Il ne s’agit pas de choisir entre méthodes traditionnelles et intelligence artificielle. La méthode la plus adaptée dépend du comportement des ventes, de l’horizon de prévision et des décisions à prendre.
La moyenne mobile atténue les fluctuations récentes et convient à une demande relativement stable. Le lissage exponentiel accorde plus de poids aux observations les plus récentes et peut tenir compte de la tendance et de la saisonnalité. Les modèles de séries chronologiques analysent les relations entre les différentes périodes, tandis que les approches causales intègrent des facteurs comme le prix, les promotions ou la météo. Les algorithmes de machine learning permettent, quant à eux, d’identifier des relations plus complexes et de traiter un grand nombre de séries et de variables.
Un modèle complexe n’est pas nécessairement plus précis. Pour une série courte et stable, une méthode simple peut fournir de meilleurs résultats. En revanche, lorsqu’il faut prévoir la demande pour des milliers de combinaisons entre produits et points de vente, la sélection automatique du modèle devient particulièrement utile. Plusieurs méthodes peuvent alors être testées sur des périodes passées afin de retenir, pour chaque série, celle qui génère le moins d’erreurs.
Enfin, une prévision ne devrait pas se limiter à un volume unique. Elle doit aussi donner une indication sur son niveau d’incertitude, par exemple à travers un intervalle de confiance. Cette information permet d’ajuster les stocks, de comparer plusieurs scénarios et de mesurer le risque associé à chaque décision.

Comment mesurer la qualité d’une prévision ?
Comparer la prévision aux ventes réalisées permet d’identifier les erreurs, à condition que la période observée n’ait pas été contrainte par une rupture. Les indicateurs de performance doivent être choisis selon l’usage et le niveau d’agrégation.
Le biais indique si les prévisions sont durablement trop hautes ou trop basses. Une mesure d’erreur absolue exprime l’ampleur moyenne des écarts. Les pourcentages sont faciles à communiquer, mais deviennent instables lorsque les ventes réelles sont faibles ou nulles. Une métrique pondérée peut mieux refléter la contribution des références importantes.
Aucun KPI ne résume à lui seul la qualité du processus de prévision. Une erreur moyenne correcte peut masquer une forte sous-prévision sur les produits prioritaires. Il faut suivre la précision par segment, horizon, canal et niveau hiérarchique, puis relier ces résultats à des indicateurs opérationnels : disponibilité, ruptures, surstocks, démarque, rotation et respect des capacités.
Le suivi doit comparer le modèle à une référence simple, par exemple la vente de la période précédente ou de l’année précédente. Si une solution avancée ne fait pas mieux que cette base, sa complexité n’est pas justifiée. Cette comparaison protège aussi contre une amélioration apparente due à un changement de périmètre.
Comment prévoir la demande d’un nouveau produit sans historique ?
Un nouveau produit ne dispose pas de données propres, mais il n’est pas nécessairement dépourvu de repères. La prévision peut utiliser un article analogue partageant catégorie, prix, format, marque, canal ou saison de lancement. L’historique du produit comparable est ajusté selon les différences de distribution, de positionnement et de calendrier.
Les intentions commerciales, tests, précommandes et données de recherche peuvent compléter cette analogie. La prévision initiale reste toutefois plus incertaine. Elle doit être présentée sous forme de scénarios, avec une hypothèse basse, centrale et haute, puis recalculée rapidement dès l’arrivée des premières ventes.
L’erreur fréquente consiste à prolonger le rythme des premiers jours sans tenir compte de l’effet de lancement. Une autre consiste à conserver trop longtemps l’analogue initial alors que le produit révèle son propre comportement. Le système doit progressivement transférer le poids vers les observations réelles.
Excel suffit-il pour analyser les données historiques ?
Excel reste pertinent pour explorer un jeu de données limité, vérifier une hypothèse, produire une première visualisation ou calculer une moyenne mobile. Sa souplesse facilite les analyses ponctuelles. Les limites apparaissent lorsque le nombre de produits, de sites, de canaux et de recalculs augmente.
Un processus dépendant de copies manuelles devient difficile à reproduire et à auditer. Les formules peuvent diverger entre fichiers, les corrections ne sont pas toujours tracées et le temps de traitement réduit la fréquence des prévisions. La consolidation de plusieurs sources ajoute encore des risques.
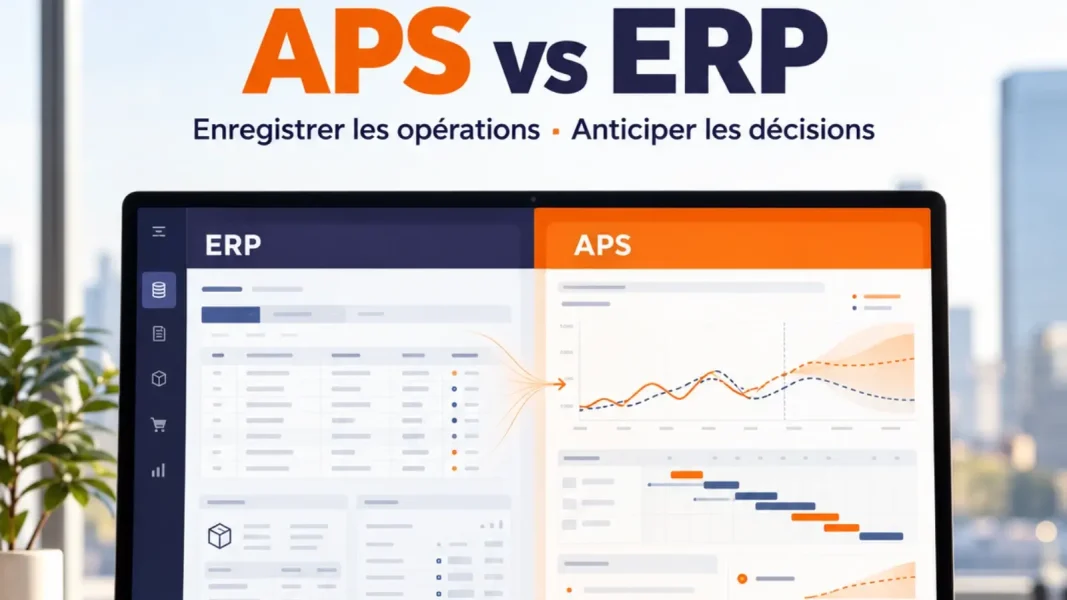
Un logiciel de prévision devient pertinent lorsque l’entreprise doit automatiser la collecte, nettoyer les historiques, tester plusieurs modèles, gérer les exceptions et diffuser des résultats cohérents aux approvisionnements. Le changement d’outil ne dispense pas de définir les règles métier. Il les rend explicites, répétables et contrôlables.
Quel rôle joue l’intelligence artificielle dans l’analyse des historiques de ventes ?
L’intelligence artificielle élargit la capacité à traiter des volumes importants, intégrer des variables exogènes et détecter des relations complexes. Elle peut sélectionner un modèle par série, ajuster ses paramètres et réagir plus rapidement à de nouvelles observations. Dans le retail, cet apport devient décisif lorsque les prévisions portent sur un grand nombre de couples article-site.
Elle ne transforme pourtant pas une donnée défaillante en signal fiable. Une rupture non identifiée, une promotion mal codée ou un référentiel instable reste un problème, quel que soit l’algorithme. Le machine learning peut même apprendre plus efficacement les biais présents dans l’historique.
L’enjeu réside dans l’association de trois niveaux : données préparées, modèles adaptés et validation métier. L’automatisation traite les séries courantes, tandis que les alertes orientent l’attention vers les écarts significatifs, les changements de comportement et les références importantes. Le rôle humain évolue alors de la manipulation répétitive vers l’analyse des exceptions et des hypothèses.
Comment intégrer l’historique des ventes au processus de demand planning ?
Une prévision statistique n’est utile que si elle s’intègre dans les décisions opérationnelles. Le demand planning permet de construire une prévision de référence, de l’enrichir avec les informations disponibles, de la valider, puis de la transmettre aux différentes étapes de la supply chain.
Le processus doit suivre un calendrier partagé, avec une date d’extraction, un horizon de prévision, une fréquence de mise à jour et des règles de validation clairement définies. Les ajustements métier doivent répondre à un événement identifié, comme une promotion, un lancement de produit ou une évolution de la distribution.
Comparer la précision de la prévision statistique à celle de la prévision finale permet ensuite de vérifier si ces ajustements améliorent réellement les résultats. Cette analyse aide à repérer les informations qui apportent de la valeur et à limiter les corrections manuelles dont l’utilité n’est pas démontrée.
Une fois validée, la prévision guide les approvisionnements, les capacités logistiques, le transport et les objectifs de stock. Les écarts entre les volumes prévus et réalisés servent ensuite à ajuster les modèles et les règles de prévision. L’historique ne reste donc pas une simple archive : il alimente une amélioration continue du processus.
Quels tableaux de bord mettre en place ?
Un tableau de bord utile ne juxtapose pas toutes les métriques disponibles. Il doit permettre de comprendre la demande, contrôler la prévision et agir sur les conséquences opérationnelles.
Une première vue suit la qualité des données : couverture de l’historique, valeurs manquantes, ruptures détectées, anomalies et fraîcheur des sources. Une deuxième mesure la performance prévisionnelle : erreur, biais, précision par horizon et valeur ajoutée des ajustements. Une troisième relie la prévision aux stocks : disponibilité, risque de rupture, excédent, rotation et couverture.
La visualisation par exception est plus efficace qu’une revue exhaustive. Elle fait ressortir les changements de niveau, les erreurs persistantes, les promotions à fort impact ou les références dont l’incertitude menace le service. Les seuils doivent tenir compte de la valeur et de la criticité du produit ; un écart de 20 unités n’a pas la même portée sur toutes les séries.
Les erreurs qui réduisent la valeur de l’historique
La première erreur est de considérer les ventes comme le reflet exact de la demande. La deuxième consiste à corriger les anomalies sans chercher à en comprendre l’origine. Un traitement automatique peut alors supprimer une information commerciale utile.
Une autre erreur fréquente est d’agréger les données trop tôt. Une tendance stable à l’échelle nationale peut masquer des évolutions très différentes selon les magasins. Mais travailler sur des séries trop détaillées et comportant peu de ventes peut également réduire la fiabilité des prévisions. Il faut donc trouver le niveau d’analyse adapté et assurer la cohérence des résultats entre les différents niveaux de la hiérarchie produit-site.
Il est également risqué de conserver la même méthode de prévision dans le temps. Le comportement d’une référence évolue au fil de son cycle de vie, de sa distribution ou de la pression concurrentielle. Les modèles doivent donc être régulièrement évalués et ajustés.
Enfin, la précision statistique ne doit pas devenir une fin en soi. Un modèle peut afficher de bons résultats tout en restant difficile à exploiter en raison de son temps de calcul, de son instabilité ou de son manque de lisibilité. La méthode la plus pertinente reste celle qui améliore réellement les décisions opérationnelles.
Faire de l’historique un actif de décision
Accumuler des années de données ne suffit pas à fiabiliser les prévisions. Si les ruptures sont interprétées comme une baisse de la demande ou si les pics promotionnels sont considérés comme des ventes habituelles, les erreurs se répercutent directement sur les stocks, les approvisionnements et la disponibilité des produits.
La valeur de l’historique dépend donc de la capacité à distinguer les ventes réalisées de la demande réelle, à expliquer les variations observées et à appliquer une méthode adaptée au comportement de chaque produit. Une fois fiabilisé, il permet d’identifier les tendances, la saisonnalité et les effets promotionnels, mais aussi de mesurer l’incertitude et de comparer plusieurs scénarios.
L’automatisation et les modèles prédictifs facilitent ce travail lorsque les volumes de données augmentent. Ils ne remplacent toutefois ni la qualité des données ni la validation métier.
Un historique des ventes utile ne se contente pas de montrer ce qui a été vendu. Il aide à comprendre les ventes perdues, à anticiper la demande future et à prendre de meilleures décisions en matière de stocks et d’approvisionnement.
FAQ – Historique des ventes
Combien de temps d’historique faut-il pour établir une prévision ?
Cela dépend du produit. Une année de ventes permet souvent d’observer les variations saisonnières, mais elle ne suffit pas toujours si les ventes sont très irrégulières. Pour un produit récent, les ventes d’articles similaires peuvent aider à établir une première prévision.
Comment prévoir les ventes d’un nouveau produit sans historique ?
Les ventes de produits similaires peuvent fournir un point de départ. La prévision peut ensuite intégrer le prix, la période de lancement et les actions commerciales prévues, puis être ajustée dès que les premières ventes sont disponibles.
Faut-il utiliser toutes les années de ventes disponibles ?
Pas systématiquement. Un historique ancien peut perdre de sa pertinence si l’assortiment, les prix ou les habitudes d’achat ont changé. La période retenue doit rester représentative de la situation que l’on cherche à prévoir.
À quelle fréquence faut-il actualiser les prévisions ?
La fréquence dépend du rythme des ventes et des décisions à prendre. Les produits à forte rotation ou soumis à des promotions demandent un suivi plus rapproché que les références stables. L’essentiel est d’actualiser la prévision assez tôt pour pouvoir agir sur les approvisionnements.