Suivre les prix de quelques dizaines de produits concurrents peut encore se faire manuellement. Dès que l’assortiment compte plusieurs milliers de références, que les tarifs évoluent fréquemment et que plusieurs enseignes ou marketplaces doivent être surveillées, cette méthode atteint vite ses limites. Les équipes consacrent alors une part importante de leur temps à rechercher des prix, vérifier les correspondances entre produits et consolider des fichiers qui peuvent être obsolètes avant même leur analyse.
Le price scraping, ou scraping de prix, automatise cette collecte sur les sites e-commerce. Il permet de suivre plus régulièrement les offres concurrentes et de disposer d’une base factuelle pour analyser son positionnement. Mais la quantité de données recueillies ne garantit pas leur valeur. Un prix n’est utile que si le produit est correctement identifié, si la promotion et la disponibilité sont comprises et si l’information peut être reliée à une décision pricing.
La question n’est donc pas seulement de savoir comment collecter les prix des concurrents. Il faut déterminer quelles données suivre, comment les fiabiliser et de quelle manière les transformer en indicateurs exploitables sans aligner automatiquement ses tarifs sur les offres les plus basses.
Qu’est-ce que le Scraping des prix ?
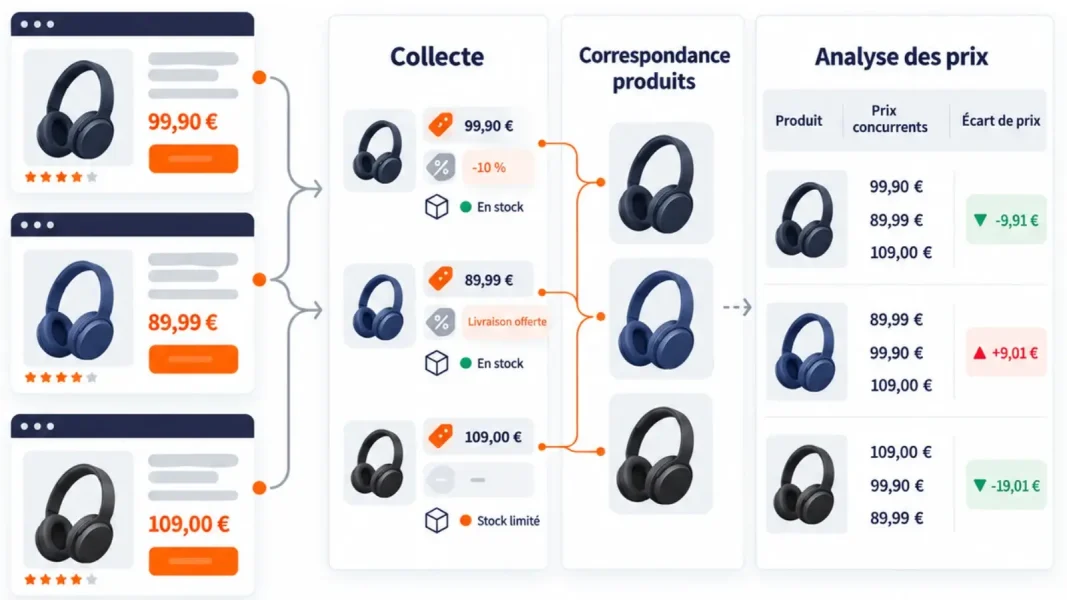
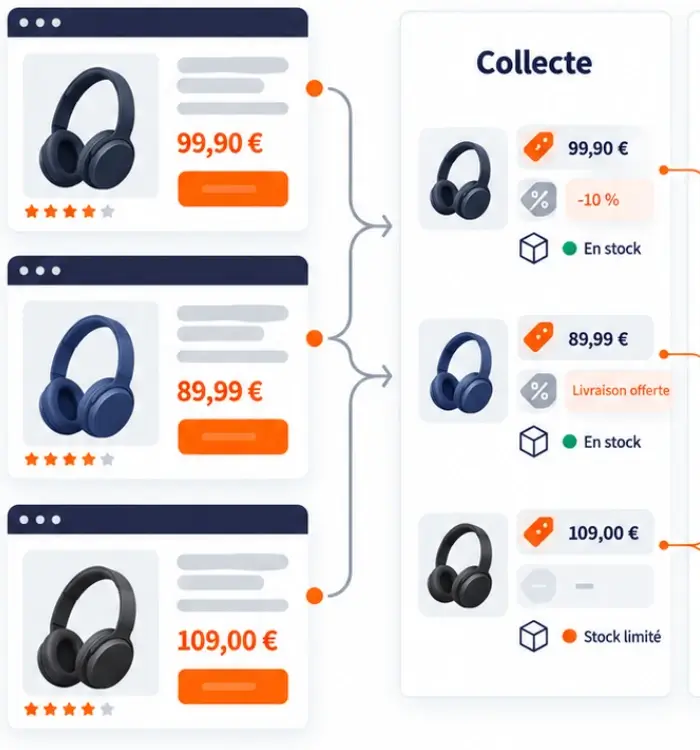
Le price scraping est une technique d’extraction automatisée des informations tarifaires publiées sur des pages web. Un programme parcourt les URL sélectionnées, identifie les champs utiles, extrait leur contenu puis restitue les données dans un format structuré.
La collecte peut notamment porter sur :
- le prix catalogue, le prix remisé et le prix barré ;
- le montant ou le pourcentage d’une promotion ;
- les offres réservées aux membres d’un programme de fidélité ;
- les codes promotionnels, coupons, lots et bundles ;
- les frais et conditions de livraison ;
- la disponibilité du produit ;
- le vendeur présent sur une marketplace ;
- l’horodatage de chaque relevé.
Contrairement aux moteurs de recherche, qui indexent des contenus pour répondre à des requêtes, un dispositif de scraping extrait des champs définis sur des sites ciblés. Il ne poursuit pas un objectif de référencement naturel : il constitue une donnée structurée qui alimente une veille concurrentielle.
Pourquoi le scraping des prix est-til important ?
Pourquoi faut-il scraper les prix de ses concurrents ? Le price scraping permet aux retailers de disposer d’une vision régulière et structurée des prix pratiqués par leurs concurrents. À grande échelle, il devient possible de suivre davantage de références, d’enseignes et de canaux qu’avec une veille manuelle, mais surtout de détecter les évolutions du marché : baisse de prix, nouvelle promotion, changement de positionnement ou apparition d’un produit concurrent.
Ces données alimentent ensuite l’analyse de la compétitivité prix. Elles permettent notamment de calculer un indice prix, de mesurer les écarts avec les concurrents et de suivre leur évolution. Le benchmark concurrentiel peut également être affiné par catégorie, marque, zone géographique, canal ou rôle du produit dans l’assortiment.
Pour autant, chaque variation détectée ne doit pas entraîner automatiquement une modification de prix. Une baisse sur un produit très visible et directement comparable n’a pas le même impact qu’une remise ponctuelle sur une référence secondaire. En croisant les données issues du scraping avec les ventes, l’élasticité, les stocks ou encore la marge, le retailer peut mieux hiérarchiser les écarts qui nécessitent réellement une action.
L’objectif n’est donc pas de s’aligner systématiquement sur le concurrent le moins cher. Une telle stratégie risquerait d’alimenter une course à la baisse et de dégrader la rentabilité. La compétitivité prix consiste plutôt à déterminer sur quels produits être offensif, lesquels maintenir au niveau du marché et où préserver davantage de marge.
Avant d’appliquer une nouvelle stratégie tarifaire, la simulation permet enfin d’évaluer son impact potentiel sur les ventes, la marge ou l’indice prix. Le suivi des résultats permet ensuite d’ajuster les décisions. Le scraping des prix devient ainsi une source d’information au service du pilotage pricing, plutôt qu’un simple mécanisme d’alignement sur la concurrence.

Comment fonctionne le price scraping ?
Un projet de scraping tarifaire commence par la définition d’un périmètre précis : sites concurrents, catégories, références, zones géographiques, canaux et fréquence de collecte. Chercher à tout surveiller génère surtout un volume important de données difficiles à exploiter. Le choix des sources et des produits doit donc répondre à des besoins précis : suivre les références qui influencent l’image prix, contrôler les promotions, repérer l’arrivée de nouveaux concurrents ou mesurer les écarts sur une catégorie prioritaire.
Une fois ce périmètre défini, le collecteur parcourt les pages sélectionnées et extrait les informations recherchées. Les devises, unités de mesure, dates et mécaniques promotionnelles sont ensuite harmonisées pour faciliter les comparaisons. Des contrôles permettent également de repérer les données manquantes, les variations inhabituelles ou les changements apportés à la structure des sites.
La fréquence des relevés dépend du secteur d’activité et du rythme auquel les prix évoluent. Pour certaines catégories, une collecte quotidienne suffit. D’autres, soumises à des variations plus rapides, nécessitent un monitoring plus régulier. Des relevés trop espacés risquent de laisser passer des mouvements importants. À l’opposé, multiplier les collectes sans besoin précis alourdit les volumes et les coûts sans apporter davantage de valeur à l’analyse.
Les données sont enfin conservées dans le temps et restituées dans un tableau de bord, sous forme d’indicateurs ou d’alertes intégrées aux outils pricing. Cet historique permet de différencier une variation ponctuelle d’une évolution plus durable, mais aussi de mesurer la durée réelle d’une promotion.
Price scraping : le matching produit, clé de fiabilité des prix collectés
Le price scraping permet de collecter à grande échelle les prix affichés sur les sites concurrents. Mais récupérer un prix ne suffit pas : encore faut-il savoir à quel produit il correspond et s’assurer que la comparaison porte sur des références réellement comparables. C’est précisément le rôle du matching produit, une étape déterminante dans la fiabilité du scraping de prix.
Lorsque l’EAN est disponible et identique, le rapprochement est relativement simple. Mais dans la pratique, de nombreuses fiches produits ne l’affichent pas, les intitulés diffèrent d’un site à l’autre et certaines enseignes proposent des formats ou des références spécifiques. Les données issues du price scraping doivent alors être rapprochées à partir de plusieurs attributs : marque, désignation, contenance, format, composition, couleur, parfum, modèle ou caractéristiques techniques.
Des algorithmes de matching peuvent analyser ces informations, proposer des correspondances entre les produits collectés et attribuer un score de confiance. Les situations ambiguës doivent toutefois pouvoir être contrôlées. Une bouteille de 1,25 litre ne doit par exemple pas être associée automatiquement à un format de 1,5 litre au seul motif que la marque et le parfum sont identiques. Le prix au litre peut faciliter l’analyse, sans pour autant rendre les deux références strictement équivalentes.
La qualité d’un dispositif de scraping de prix dépend donc autant de la capacité à collecter les données que de la précision avec laquelle les produits sont identifiés et rapprochés. Un mauvais matching peut fausser l’analyse concurrentielle, générer de fausses alertes de prix et conduire à des décisions de repositionnement injustifiées.
La performance ne doit ainsi pas être évaluée uniquement au volume de pages ou de prix scrapés. Taux de couverture, taux de matching, niveau de confiance des correspondances et rapidité de traitement des anomalies sont également essentiels pour disposer d’une veille tarifaire réellement exploitable.
Quelles données faut-il collecter au-delà du prix ?
Le tarif affiché ne représente qu’une partie de l’offre. Pour mener une analyse concurrentielle fiable, il faut également tenir compte des conditions promotionnelles, de la disponibilité, du vendeur, du canal et du moment où le prix a été relevé.
Toutes les promotions ne se comparent pas de la même manière. Une remise immédiate, un avantage fidélité, un coupon différé ou une offre par lot répondent à des conditions différentes. Le prix de référence doit donc être conservé pour mesurer la réduction réellement proposée au client.
La disponibilité joue également un rôle essentiel. Le prix d’un produit en rupture n’exerce pas la même pression concurrentielle que celui d’un article disponible immédiatement. S’aligner sur une offre inaccessible peut ainsi réduire la marge sans générer de ventes supplémentaires.
L’analyse doit aussi identifier le vendeur, le canal et la zone géographique concernés. Sur une marketplace, le prix peut être proposé par un vendeur tiers. Il peut également varier entre le site et le magasin, ou d’une localisation à l’autre. Comparer ces offres sans les contextualiser revient à rapprocher des situations commerciales qui ne sont pas équivalentes.
Enfin, chaque relevé doit être précisément horodaté, car les prix, les stocks et les promotions n’évoluent pas toujours au même rythme. La constitution d’un historique permet de suivre la fréquence des changements, d’évaluer la stabilité du positionnement concurrentiel et de distinguer une opération ponctuelle d’une évolution plus durable.
Quelles sont les limites du price scraping ?
Les sites modifient leurs pages, chargent certains contenus dynamiquement ou présentent des informations différentes selon la localisation. Un champ peut disparaître sans que le prix ait réellement cessé d’exister. Le dispositif doit donc être surveillé et corrigé.
La deuxième limite tient au périmètre. Le web ne restitue pas nécessairement les prix pratiqués en magasin, le merchandising, les ruptures en rayon ou les promotions locales. Pour une enseigne omnicanale, les relevés terrain restent complémentaires du scraping en ligne. Leur consolidation évite de construire le benchmarking sur une vision partielle du marché.
Des millions de relevés ne compensent ni un matching incertain ni une mauvaise définition des concurrents pertinents. Sans priorisation, les équipes ne distinguent plus une anomalie technique d’un mouvement significatif.
Enfin, la collecte doit respecter les règles applicables aux sources consultées, la protection des données et les conditions d’accès. Les pratiques doivent être encadrées sur les plans technique, contractuel et juridique. Cette gouvernance fait partie du projet au même titre que la performance de collecte.

Price scraping : quelle solution utiliser ?
Le choix dépend moins du volume théorique de données que des capacités internes, du niveau de personnalisation attendu et de l’usage final.
Un outil autonome convient aux organisations qui disposent de compétences techniques et veulent contrôler leurs collecteurs. Il apporte de la souplesse, mais l’entreprise prend en charge la maintenance, la normalisation, le stockage, le contrôle qualité et souvent le matching.
Une agence peut concevoir et maintenir un dispositif sur mesure. Il faut préciser ce que couvre la prestation : collecte, incidents, rapprochement produit, historique, restitution, délais de remise en service et propriété des données. Un fichier de prix ne constitue pas encore un outil d’aide à la décision.
Une plateforme spécialisée associe généralement collecte, matching, contrôles qualité, historique, indicateurs et intégration aux processus pricing. Elle répond à un usage durable partagé par plusieurs équipes. Sa valeur dépend de sa capacité à restituer les bons écarts, pas seulement un grand volume de prix.
Pour comparer les options, six critères sont déterminants :
- la couverture des enseignes, canaux et zones utiles ;
- la fiabilité du matching et le traitement des cas ambigus ;
- la prise en compte des promotions, stocks, vendeurs et frais ;
- la fraîcheur des données et la gestion des incidents ;
- l’intégration aux outils d’analyse et aux workflows pricing ;
- le coût total, incluant maintenance, contrôle et mobilisation des équipes.
La meilleure solution n’est donc pas nécessairement celle qui collecte le plus. C’est celle qui fournit une donnée suffisamment fiable, fraîche et contextualisée pour répondre aux décisions prioritaires.
Comment transformer les données en décisions pricing ?
Le projet doit commencer par les questions métier. Sur quelles références l’enseigne veut-elle défendre son image prix ? Quels concurrents directs influencent réellement ses clients ? Quels écarts nécessitent une alerte ? Quelle marge de manœuvre existe avant de modifier un tarif ?
Ces questions déterminent le périmètre, la fréquence et le niveau de détail. Les résultats doivent ensuite être reliés aux ventes, marges, stocks, élasticité, promotions et segments produits. Un écart change de signification selon le volume vendu, la demande et le rôle de la référence.
Le pilotage peut s’appuyer sur quelques indicateurs : indice prix, part de produits moins chers ou plus chers, amplitude des écarts, couverture du matching et fréquence des changements. Les outils d’analyse doivent relier la synthèse aux références qui expliquent le résultat.
Les alertes gagnent enfin à être hiérarchisées selon leur impact potentiel. Au lieu de signaler chaque variation, le système peut isoler les mouvements durables, les produits à forte visibilité ou les écarts dépassant un seuil défini. Les équipes consacrent alors leur temps à l’analyse et à la décision plutôt qu’au contrôle de fichiers.
Exemple concret de price scraping
Prenons un retailer qui souhaite suivre le prix d’un paquet de café vendu sur son site et chez cinq concurrents directs. Le dispositif consulte chaque fiche produit plusieurs fois par jour et relève le prix affiché, la promotion, le prix au kilo, la disponibilité et les frais de livraison.
À 9 heures, un concurrent propose le paquet à 5,90 euros. À 14 heures, le même produit apparaît à 4,90 euros. Pris isolément, ce changement pourrait justifier une alerte. Une analyse plus complète montre toutefois que le second prix est réservé aux membres, qu’il faut acheter deux unités et que le produit n’est plus disponible en livraison dans plusieurs zones.
Cet exemple illustre la différence entre extraire un nombre et interpréter une offre. Si la donnée collectée se limite au tarif de 4,90 euros, le retailer risque de comparer deux propositions commerciales différentes et de réduire inutilement son prix. Une collecte pertinente doit préserver le contexte qui donne son sens à l’information.
Le même raisonnement vaut sur une marketplace. Une fiche peut regrouper plusieurs vendeurs, chacun avec son prix, son stock, ses frais de port et ses délais. Le prix visible au moment du relevé n’est pas toujours celui de l’enseigne surveillée ni l’offre réellement accessible à tous les clients.
Du relevé automatisé au pilotage de la performance prix
Lorsque les prix évoluent fréquemment sur des milliers de références et plusieurs canaux, le suivi manuel ne permet plus de disposer d’une vision suffisamment complète et à jour. Le price scraping répond à cette limite en automatisant la collecte, mais parcourir davantage de pages ne suffit pas à améliorer les décisions pricing.
La fiabilité de la veille dépend d’abord de la qualité des correspondances entre les produits. Chaque offre doit ensuite être replacée dans son contexte : promotion, disponibilité, vendeur, canal, zone géographique et moment du relevé. L’historique permet de distinguer une variation ponctuelle d’un changement plus durable, tandis que les relevés en magasin complètent les informations qui ne sont pas accessibles en ligne.
L’objectif n’est donc pas de réagir à chaque mouvement observé chez les concurrents. Il s’agit d’identifier les écarts qui méritent une attention particulière, puis d’en mesurer les effets possibles sur les ventes, l’image prix et la marge. Le price scraping apporte le signal ; la qualité du matching, l’analyse et la simulation permettent de déterminer s’il faut ajuster un prix, maintenir son positionnement ou ne pas intervenir.