Um die Nachfrage zu prognostizieren, muss man zunächst verstehen, was in der Vergangenheit verkauft wurde. Die Verkaufshistorie lässt sich jedoch nicht ohne Weiteres interpretieren. Die verzeichneten Absatzmengen hängen von zahlreichen Faktoren ab: der Kundennachfrage, der Produktverfügbarkeit, dem Preis, Werbeaktionen oder auch dem Vertriebskanal. Ist ein Artikel nicht vorrätig, brechen die Verkaufszahlen ein, ohne dass die Nachfrage zwangsläufig zurückgegangen ist. Umgekehrt kann eine Werbeaktion einen einmaligen Spitzenwert auslösen, der sich nicht wiederholen wird.
Die Verkaufshistorie stellt somit keine Prognose dar. Sie bildet das Ausgangsmaterial, anhand dessen Trends, Zyklen und vergangene Ereignisse analysiert werden können. Ihr Wert hängt weniger von der Menge der gesammelten Daten ab als vielmehr von der Fähigkeit, zu erklären, was die einzelnen Beobachtungen bedeuten.
Für Einzelhändler, die Tausende von Artikeln verwalten, hat diese Unterscheidung direkte Auswirkungen auf die Bedarfsplanung, die Beschaffung und die Lagerbestände. Eine falsche Interpretation der Daten kann zu übermäßigen Bestellungen, Lieferengpässen, unnötigen Umlagerungen oder erhöhten Preisnachlässen führen.
In diesem Artikel werden wir untersuchen, wie sich die Verkaufshistorie strukturieren, bereinigen und analysieren lässt, umdie Nachfrageprognose zuverlässiger zu gestalten und fundiertere Entscheidungen zu treffen.
Was ist eine Verkaufshistorie?
Die Verkaufshistorie fasst die in einem vergangenen Zeitraum getätigten Transaktionen zusammen. Jede Zeile enthält in der Regel ein Datum, ein Produkt, eine verkaufte Menge, eine Verkaufsstelle oder einen Vertriebskanal, einen Preis und einen Umsatzbetrag. Je nach Informationssystem können weitere Attribute verfügbar sein: Rabatt, Sonderaktion, Rückgabe, Stornierung, Lagerbestand zum Zeitpunkt des Verkaufs, Identität des Lieferanten, Lieferfrist oder Kundenmerkmale.
Kassendaten erfassen den Warenausgang aus dem Geschäft, während E-Commerce-Bestellungen bei der Bestätigung, beim Versand oder bei der Lieferung erfasst werden können. Eine aussagekräftige Analyse beginnt daher mit der genauen Definition des gemessenen Ereignisses.
Die Granularität ist ebenso entscheidend. Eine monatliche Umsatzsumme mag für ein Haushaltsjahr ausreichend sein, verschleiert jedoch die wöchentlichen Spitzenwerte, die für die Beschaffung von Bedeutung sind. Eine tägliche Datenreihe zeigt zwar mehr Schwankungen auf, geht jedoch mit einem höheren Rauschpegel einher. Schließlich lässt sich anhand einer nach Kategorien konsolidierten Zeitreihe nicht jedes einzelne Produkt und jeder Standort vorhersagen. Die Daten müssen auf der Ebene verfügbar sein, auf der die Entscheidung getroffen wird, oder auf einer Ebene, die eine kontrollierte Aufschlüsselung ermöglicht.
Verkaufsverlauf und historische Daten: Worin besteht der Unterschied?
Die historischen Daten beschränken sich nicht nur auf die Verkaufszahlen. Sie können auch Lagerbestände, Lieferengpässe, nicht ausgelieferte Bestellungen, Preise, Werbeaktionen, Rücksendungen, Lieferzeiten der Lieferanten, Besucherzahlen, den Kalender oder auch das Wetter umfassen. Die Verkaufshistorie zeigt, was gekauft wurde, während die zugehörigen Daten Aufschluss über die beobachteten Schwankungen geben.
Sie helfen insbesondere dabei, einen tatsächlichen Nachfragerückgang von einem durch einen Lagerengpass verursachten Rückgang oder ein nachhaltiges Wachstum von einem einmaligen Anstieg aufgrund einer Werbeaktion zu unterscheiden.

Warum ist die Verkaufshistorie für die Nachfrageprognose unverzichtbar?
Bei der Prognose geht es darum, anhand der verfügbaren Informationen die zukünftigen Umsätze zu schätzen. Anhand der historischen Daten lassen sich vier Hauptkomponenten analysieren: das durchschnittliche Nachfrageniveau, dessen Entwicklung, die saisonalen Schwankungen sowie die Schwankungen, die sich nicht durch das Modell erklären lassen.
Der Durchschnittswert liefert eine erste Größenordnung. Der Trend zeigt an, ob die Umsätze steigen, sinken oder sich ihr Tempo nachhaltig verändert. Die Saisonalität verdeutlicht Schwankungen, die sich je nach Tag, Woche oder Jahreszeit wiederholen. Schließlich können die Restschwankungen auf Zufälle, einmalige Ereignisse, Datenfehler oder Faktoren zurückzuführen sein, die nicht berücksichtigt wurden.
Der Anteil der einzelnen Komponenten variiert je nach Produkt. Der Absatz eines Lebensmittels kann einem regelmäßigen wöchentlichen Rhythmus folgen, der eines Gartenartikels hängt stark vom Wetter ab, während ein Ersatzteil möglicherweise in weitaus unregelmäßigeren Abständen verkauft wird. Würde man dieselbe Methode auf alle Artikel anwenden, könnten diese Unterschiede nicht berücksichtigt werden.
Die Analyse der historischen Daten hilft somit dabei, das Verhalten jeder einzelnen Absatzreihe zu ermitteln, bevor die am besten geeignete Prognosemethode ausgewählt wird. Sie ermöglicht es zudem, die Artikel anhand ihres Profils zu gruppieren, die Häufigkeit der Aktualisierungen festzulegen und anschließend die Prognosen mit den tatsächlich verzeichneten Absatzzahlen zu vergleichen.
Spiegeln die bisherigen Verkaufszahlen noch immer die tatsächliche Nachfrage wider?
Nein! Die Verkaufszahlen spiegeln die befriedigte Nachfrage wider, nicht unbedingt die geäußerte Nachfrage. Wenn das Produkt verfügbar ist und angemessen präsentiert wird, kann die Abweichung gering sein. Sobald das Angebot den Kauf einschränkt, unterschätzt die historische Datenlage das tatsächliche Potenzial.
Ein Lagerengpass ist der offensichtlichste Fall. Wenn der Lagerbestand drei Tage lang bei Null liegt, lassen sich anhand der in diesen drei Tagen verzeichneten Umsätze nicht ermitteln, was die Kunden gekauft hätten. Ein Teil der Nachfrage geht verloren, ein anderer Teil verlagert sich auf ein ähnliches Produkt, eine andere Filiale oder einen Wettbewerber. Werden die Nullwerte ohne Korrektur wieder in das Modell eingespeist, lernt der Algorithmus, dass ein Nachfragerückgang stattgefunden hat, obwohl es sich in Wirklichkeit um eine Unmöglichkeit des Verkaufs handelte.
Weitere Faktoren führen zu derselben Diskrepanz: außerplanmäßige Schließung, Ausfall der Website, verspätete Listung, vorübergehende Rücknahme oder ausgelastete Produktionskapazitäten. Im Gegensatz dazu kann eine Werbeaktion oder eine Hervorhebung den Absatz steigern, ohne die Grundnachfrage nachhaltig zu verändern.
Die Rekonstruktion der Nachfrage besteht darin, diese Zeiträume zu korrigieren oder mit Anmerkungen zu versehen. Dies bedeutet nicht, jeden atypischen Wert willkürlich zu ersetzen. Es gilt, die Ursache zu ermitteln, das nicht beobachtete Volumen anhand einer dokumentierten Regel zu schätzen und die Rohdaten zur Gewährleistung der Rückverfolgbarkeit aufzubewahren. Die Prognose gewinnt dadurch an Zuverlässigkeit, ohne die operative Historie des Produkts zu löschen.
Welche Daten sollten mit der Verkaufshistorie verknüpft werden?
Eine Reihe von Mengenangaben und Zeitpunkten reicht aus, um eine erste statistische Prognose zu erstellen. Diese stößt jedoch an ihre Grenzen, sobald die Nachfrage stark auf geschäftliche Entscheidungen oder externe Faktoren reagiert. Welche Datenquellen miteinander abgeglichen werden müssen, hängt von der Branche und dem Produkt ab, doch bestimmte Kategorien tauchen regelmäßig auf.
Die Produktdaten beschreiben die Artikelnummer, die Kategorie, den Status und den Lebenszyklus des Artikels. Die Vertriebsdaten umfassen den Preis, Werbeaktionen und Sortimentsänderungen. Die Bestandsdaten geben Auskunft über die Verfügbarkeit, Fehlbestände und Wareneingänge. Der Kalender kennzeichnet Feiertage, Ferien, Schlussverkäufe oder lokale Veranstaltungen. Bestimmte exogene Variablen wie das Wetter, die Inflation oder die Preise der Wettbewerber können ebenfalls die Nachfrage beeinflussen.
Das Ziel besteht nicht darin, alle verfügbaren Datenbanken miteinander zu verknüpfen. Jede Quelle muss zur Erklärung oder Vorhersage eines Verhaltens beitragen. Das Hinzufügen von Hunderten unzuverlässiger Variablen erhöht die Komplexität, verlangsamt die Verarbeitungsprozesse und kann die Robustheit der Modelle beeinträchtigen. Die entscheidenden Kriterien sind nach wie vor ihre Erklärungskraft, ihre zukünftige Verfügbarkeit und ihre Qualität im Laufe der Zeit.
Eine Variable, die erst nach dem zu prognostizierenden Zeitraum bekannt ist, kann nicht direkt verwendet werden. Ebenso liefert eine externe Datenquelle, die zwar stark mit den Umsätzen korreliert, jedoch keinen Mehrwert, wenn sie nicht mit einer Frequenz und einem Zeithorizont verfügbar ist, die mit der operativen Planung vereinbar sind.
Wie bereitet man einen historischen Datenverlauf vor, bevor man ihn analysiert?
Die Aufbereitung erfordert oft einen höheren Aufwand als die Modellierung. Selbst ein ausgeklügelter Algorithmus kann doppelte Einträge, inkonsistente Datumsangaben oder Lücken, die als Nullanforderung gewertet werden, nicht ausgleichen. Der Prozess muss eine Rohversion beibehalten, eine korrigierte Reihe erstellen und jede Transformation dokumentieren.
Die Referenzrahmen harmonisieren
Änderungen von Artikelnummern, Filialzusammenlegungen oder ERP-Migrationen führen häufig zu einer Fragmentierung der Serien. Wenn alte und neue Identifikationsnummern derselben geschäftlichen Realität entsprechen, müssen sie einander zugeordnet werden. Dagegen kann die Zusammenfassung zweier unterschiedlicher Produkte unter dem Vorwand, dass ihre Bezeichnungen ähnlich sind, eine künstliche Kontinuität schaffen.
Wählen Sie eine einheitliche Granularität
Die tägliche Häufigkeit eignet sich für Produkte mit hoher Umschlagshäufigkeit, kurzfristige Veranstaltungen und häufige Nachschubentscheidungen. Die wöchentliche Häufigkeit reduziert Störsignale und erleichtert das Erkennen von Trends. Die monatliche Häufigkeit ist für einen aggregierten Überblick nützlich, oft jedoch zu ungenau, um die Lagerbestände zu steuern.
Die Wahl hängt auch von der Beschaffungsfrist ab. Die analytische Granularität muss auf die Häufigkeit der Entscheidungen abgestimmt bleiben.
Fehlende Werte und Duplikate bearbeiten
Das Fehlen eines Dateneintrags kann bedeuten, dass kein Verkauf stattgefunden hat, die Daten nicht übermittelt wurden oder die Artikelnummer nicht aktiv ist. Diese drei Situationen sind unterschiedlich zu behandeln. Doppelte Einträge können ihrerseits durch die erneute Einbindung von Dateien oder durch Transaktionen entstehen, die in mehreren Systemen erfasst wurden. Die Korrekturregeln müssen sich auf den Status des Produkts und die tatsächliche Abdeckung der Quellen stützen.
Extremwerte ermitteln
Ein ungewöhnliches Volumen muss nicht unbedingt auf einen Fehler hindeuten. Es kann auf einen Sonderauftrag, eine Werbeaktion, eine Filialeröffnung oder ein lokales Ereignis zurückzuführen sein. Das automatische Entfernen von Extremwerten entzieht dem Modell nützliche Informationen. Es ist ratsam, diese zunächst zu bewerten und dann zu entscheiden, ob sie zur wiederkehrenden Nachfrage, zu einem erklärbaren Effekt oder zu einer Datenanomalie gehören.
Unterbrechungen und nicht vergleichbare Zeiträume korrigieren
Die Korrektur kann sich auf benachbarte Tage, die entsprechenden Tage der Vorwochen, vergleichbare Geschäfte oder das Verhalten ähnlicher Artikel stützen. Je länger die Datenlücke ist, desto unsicherer wird die Schätzung. Der korrigierte Wert muss daher von einem tatsächlich beobachteten Verkauf unterschieden werden können.
Zu den nicht vergleichbaren Zeiträumen zählen auch Lockdowns, Bauarbeiten, wesentliche Sortimentsänderungen oder Kanalwechsel. Anstatt diese Zeiträume zu löschen, kann es sinnvoll sein, ihre Gewichtung zu verringern, sie durch eine Variable zu isolieren oder das Modell auf einem repräsentativeren Zeitfenster zu trainieren.

Wie weit zurück soll der Verlauf gespeichert werden?
Es gibt keine ideale Zeitspanne, die für alle Produkte gilt. Die Länge der Zeitreihe hängt vom Verkaufszyklus, der Häufigkeit der Erhebungen und der Stabilität der Nachfrage ab. Um jährliche saisonale Schwankungen zu erkennen, ist es vorteilhaft, über mehrere vergleichbare Jahre zu verfügen. Bei einem Artikel, der nur sechs Monate lang vermarktet wurde, ist ein derart langer Zeitraum weder verfügbar noch zwangsläufig aussagekräftig, selbst wenn Daten eines ähnlichen Produkts herangezogen werden.
Ein umfangreicher historischer Datenverlauf hilft dabei, Zyklen zu erkennen, kann jedoch auch Verhaltensmuster enthalten, die nach einer Veränderung des Preises, des Vertriebskanals oder des Sortiments nicht mehr der aktuellen Situation entsprechen. Ein kürzerer Zeitraum spiegelt die jüngsten Trends besser wider, misst jedoch punktuellen Schwankungen ein größeres Gewicht bei.
Es geht also nicht nur darum, wie viele Jahre berücksichtigt werden sollen, sondern auch darum, welche Zeiträume tatsächlich miteinander verglichen werden können. Es ist möglich, verschiedene Zeiträume zu testen und denjenigen auszuwählen, der die zuverlässigsten Prognosen liefert. Den ältesten Daten kann zudem eine geringere Gewichtung zugewiesen werden, insbesondere bei der exponentiellen Glättung.
Wie analysiert man eine Umsatzentwicklung?
Die Analyse beginnt mit einer einfachen Visualisierung. Eine zeitliche Kurve, aufgeschlüsselt nach Produkt und Standort, macht häufig Serienbrüche, Spitzenwerte, Niveauänderungen oder Zyklen sichtbar, die in einer Datentabelle nicht erkennbar sind. Die Dashboards müssen es ermöglichen, von einer konsolidierten Ansicht zur Einzelreihe zu wechseln, ohne dass die mit den Ereignissen verbundenen Anmerkungen verloren gehen.
Messung des Niveaus, der Streuung und der Gleichmäßigkeit
Der Mittelwert und der Median liefern zwei sich ergänzende Kennzahlen. Ein deutlicher Unterschied zwischen beiden deutet häufig auf Spitzenwerte oder eine asymmetrische Verteilung hin. Die Standardabweichung und der Variationskoeffizient messen die relative Streuung. Die Häufigkeit von Zeiträumen ohne Verkäufe hilft dabei, eine sporadische Nachfrage zu erkennen.
Diese Kennzahlen dienen auch als Orientierung für die Segmentierung und die Sicherheitsbestände. Zwei Produkte mit demselben Jahresumsatz können unterschiedliche Strategien erfordern, wenn das eine täglich verkauft wird und das andere nur in seltenen Bestellungen.
Zwischen Trend und Saisonalität unterscheiden
Der Trend spiegelt die allgemeine Entwicklung der Umsätze im Zeitverlauf wider, während die Saisonalität Schwankungen entspricht, die sich in regelmäßigen Abständen wiederholen. Dabei kann es sich um einen Anstieg jeden Samstag, einen Höhepunkt vor Weihnachten oder einen Rückgang im Sommer handeln. Anhand der saisonalen Koeffizienten lassen sich diese Schwankungen messen, sofern sichergestellt ist, dass sie sich von Jahr zu Jahr ausreichend stabil wiederholen.
Die Zerlegung der Zeitreihen ermöglicht es anschließend, das Umsatzniveau, den Trend, die Saisonalität und die Restschwankungen voneinander zu unterscheiden. Dadurch wird vermieden, dass ein Anstieg, der in Wirklichkeit auf eine allgemeine Zunahme zurückzuführen ist, einem saisonalen Effekt zugeschrieben wird. Zudem erleichtert sie den Vergleich zwischen mehreren Zeiträumen, indem sie wiederkehrende Schwankungen neutralisiert.
Nach erklärenden Faktoren suchen
Die Korrelation misst den Zusammenhang zwischen zwei Variablen, belegt jedoch keinen Kausalzusammenhang. Ein gleichzeitiger Anstieg der Verkaufszahlen und der Besucherzahlen kann auf einen Akquisitionseffekt hindeuten; er kann aber auch das Ergebnis einer Werbeaktion sein, die beide Faktoren beeinflusst. Preis, Rabatt, Verfügbarkeit, Wetter oder der Kalender müssen im Zusammenhang mit ihrem zeitlichen Verlauf und ihren Wechselwirkungen analysiert werden.
Eine Regression kann den Zusammenhang zwischen der Nachfrage und mehreren Faktoren quantifizieren. Sie erweist sich als nützlich, wenn die Variablen zuverlässig, ausreichend variabel und für die Zukunft verfügbar sind. Modelle des maschinellen Lernens erfassen komplexere Zusammenhänge, erfordern jedoch dieselben Vorsichtsmaßnahmen hinsichtlich Qualität, Verfügbarkeit und Interpretation.
Produkte nach ihrem Verhalten segmentieren
Bei der ABC-Segmentierung werden Artikel nach ihrem Beitrag zum Umsatz oder zur Marge klassifiziert. Bei der XYZ-Segmentierung werden sie nach ihrer Vorhersehbarkeit oder ihrer Schwankungsbreite unterschieden. Durch die Kombination beider Ansätze wird vermieden, dass für einen wichtigen und stabilen Artikel, einen marginalen und unberechenbaren Artikel oder ein neues Produkt der gleiche Aufwand betrieben wird.
Weitere Kriterien können die Analyse ergänzen: Verkaufsfrequenz, Lebensdauer, Reaktionsfähigkeit auf Werbeaktionen, Saisonalität und Lieferzeiten. Die Segmentierung muss zu unterschiedlichen Regeln für die Prognose und Steuerung führen; andernfalls bleibt sie rein beschreibend.
Lorem ipsum dolor sit amet, consectetur adipiscing elit. Ut elit tellus, luctus nec ullamcorper mattis, pulvinar dapibus leo.
Welche Prognosemethoden sollten auf der Grundlage vergangener Verkaufszahlen angewendet werden?
Es geht nicht darum, sich zwischen traditionellen Methoden und künstlicher Intelligenz zu entscheiden. Welche Methode am besten geeignet ist, hängt vom Absatzverhalten, vom Prognosehorizont und von den zu treffenden Entscheidungen ab.
Der gleitende Durchschnitt glättet die jüngsten Schwankungen und eignet sich für eine relativ stabile Nachfrage. Die exponentielle Glättung gewichtet die jüngsten Beobachtungen stärker und kann Trends sowie saisonale Schwankungen berücksichtigen. Zeitreihenmodelle analysieren die Zusammenhänge zwischen verschiedenen Zeiträumen, während kausale Ansätze Faktoren wie Preis, Werbeaktionen oder Wetter einbeziehen. Algorithmen des maschinellen Lernens ermöglichen es hingegen, komplexere Zusammenhänge zu erkennen und eine große Anzahl von Zeitreihen und Variablen zu verarbeiten.
Ein komplexes Modell ist nicht unbedingt genauer. Bei einer kurzen und stabilen Zeitreihe kann eine einfache Methode bessere Ergebnisse liefern. Wenn es hingegen darum geht, die Nachfrage für Tausende von Kombinationen aus Produkten und Verkaufsstellen zu prognostizieren, erweist sich die automatische Modellauswahl als besonders nützlich. In diesem Fall können mehrere Methoden anhand vergangener Zeiträume getestet werden, um für jede Zeitreihe diejenige auszuwählen, die die geringsten Fehler aufweist.
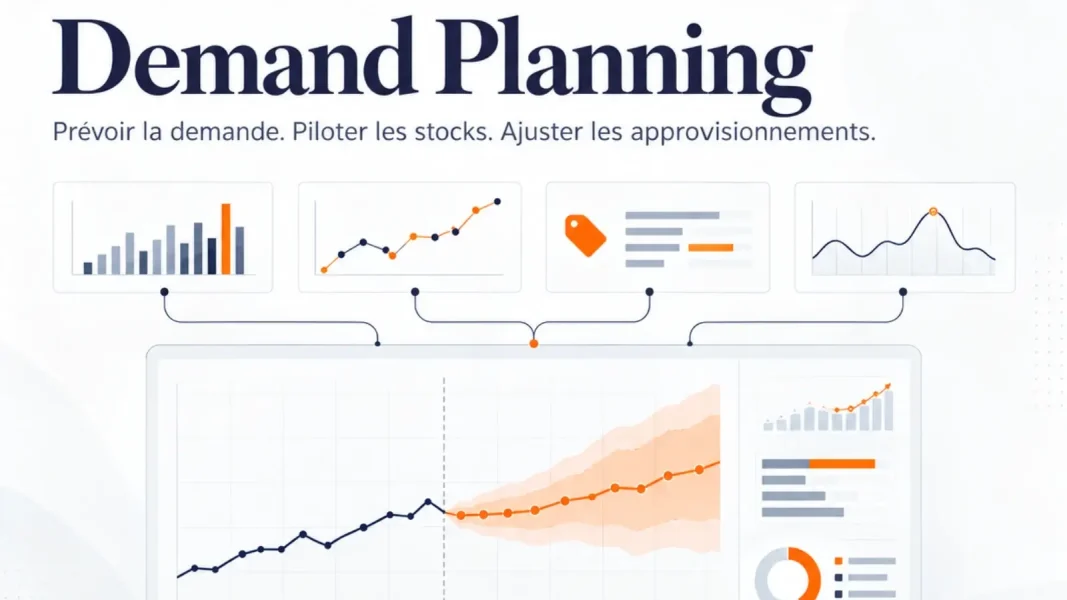
Schließlich sollte sich eine Prognose nicht auf einen einzigen Wert beschränken. Sie muss auch Aufschluss über den Grad ihrer Unsicherheit geben, beispielsweise durch Angabe eines Konfidenzintervalls. Anhand dieser Informationen lassen sich Lagerbestände anpassen, verschiedene Szenarien vergleichen und das mit jeder Entscheidung verbundene Risiko einschätzen.

Wie lässt sich die Qualität einer Prognose messen?
Durch den Vergleich der Prognose mit den tatsächlichen Verkaufszahlen lassen sich Fehler erkennen, sofern der betrachtete Zeitraum nicht durch eine Lieferunterbrechung beeinträchtigt wurde. Die Leistungsindikatoren sollten je nach Verwendungszweck und Aggregationsebene ausgewählt werden.
Die Verzerrung gibt an, ob die Prognosen dauerhaft zu hoch oder zu niedrig ausfallen. Ein Maß für den absoluten Fehler drückt das durchschnittliche Ausmaß der Abweichungen aus. Prozentangaben lassen sich leicht vermitteln, werden jedoch unzuverlässig, wenn die tatsächlichen Umsätze gering oder gleich Null sind. Eine gewichtete Kennzahl kann den Beitrag wichtiger Artikel besser widerspiegeln.
Kein einzelner KPI gibt für sich genommen die Qualität des Prognoseprozesses wieder. Ein korrekter Durchschnittsfehler kann eine starke Unterprognose bei den vorrangigen Produkten verschleiern. Die Genauigkeit muss nach Segment, Zeithorizont, Vertriebskanal und Hierarchieebene überwacht werden; anschließend sind diese Ergebnisse mit operativen Kennzahlen zu verknüpfen: Verfügbarkeit, Lieferengpässe, Überbestände, Preisnachlässe, Umschlagshäufigkeit und Kapazitätsauslastung.
Bei der Überwachung sollte das Modell mit einer einfachen Referenz verglichen werden, beispielsweise mit dem Umsatz der Vorperiode oder des Vorjahres. Wenn eine fortschrittliche Lösung keine besseren Ergebnisse erzielt als diese Basis, ist ihre Komplexität nicht gerechtfertigt. Dieser Vergleich schützt zudem vor einer scheinbaren Verbesserung, die auf eine Änderung des Vergleichsrahmens zurückzuführen ist.
Wie lässt sich die Nachfrage nach einem neuen Produkt ohne historische Daten prognostizieren?
Ein neues Produkt verfügt zwar nicht über eigene Daten, doch bedeutet dies nicht zwangsläufig, dass es keine Anhaltspunkte bietet. Für die Prognose kann ein vergleichbares Produkt herangezogen werden, das dieselbe Kategorie, denselben Preis, dasselbe Format, dieselbe Marke, denselben Vertriebskanal oder dieselbe Einführungssaison aufweist. Die historischen Daten des vergleichbaren Produkts werden entsprechend den Unterschieden in Bezug auf Vertrieb, Positionierung und Zeitplan angepasst.
Geschäftliche Absichten, Tests, Vorbestellungen und Suchdaten können diese Analogie ergänzen. Die ursprüngliche Prognose bleibt jedoch mit größeren Unsicherheiten behaftet. Sie sollte in Form von Szenarien dargestellt werden – mit einer konservativen, einer zentralen und einer optimistischen Annahme – und dann umgehend neu berechnet werden, sobald die ersten Verkaufszahlen vorliegen.
Ein häufiger Fehler besteht darin, das Tempo der ersten Tage beizubehalten, ohne den Anlaufeffekt zu berücksichtigen. Ein weiterer Fehler besteht darin, das ursprüngliche Analogon zu lange beizubehalten, obwohl das Produkt bereits sein eigenes Verhalten zeigt. Das System muss das Gewicht schrittweise auf die tatsächlichen Beobachtungen verlagern.
Reicht Excel aus, um historische Daten zu analysieren?
Excel eignet sich nach wie vor gut, um einen begrenzten Datensatz zu untersuchen, eine Hypothese zu überprüfen, eine erste Visualisierung zu erstellen oder einen gleitenden Durchschnitt zu berechnen. Seine Flexibilität erleichtert punktuelle Analysen. Grenzen treten zutage, wenn die Anzahl der Produkte, Standorte, Kanäle und Neuberechnungen zunimmt.
Ein Prozess, der auf manuellen Kopien basiert, lässt sich nur schwer reproduzieren und prüfen. Die Formeln können von Datei zu Datei voneinander abweichen, Korrekturen werden nicht immer nachverfolgt, und der Zeitaufwand für die Bearbeitung führt dazu, dass Prognosen seltener erstellt werden. Die Zusammenführung mehrerer Quellen birgt zusätzliche Risiken.
Eine Prognosesoftware ist dann sinnvoll, wenn das Unternehmen die Datenerfassung automatisieren, historische Daten bereinigen, verschiedene Modelle testen, Ausnahmen verwalten und konsistente Ergebnisse an die Beschaffungsabteilungen weiterleiten muss. Der Wechsel des Tools entbindet nicht von der Festlegung der Geschäftsregeln. Er macht diese vielmehr explizit, wiederholbar und überprüfbar.
Welche Rolle spielt künstliche Intelligenz bei der Analyse von Verkaufsdaten?
Künstliche Intelligenz erweitert die Fähigkeit, große Datenmengen zu verarbeiten, exogene Variablen einzubeziehen und komplexe Zusammenhänge zu erkennen. Sie kann für jede Zeitreihe ein Modell auswählen, dessen Parameter anpassen und schneller auf neue Beobachtungen reagieren. Im Einzelhandel wird dieser Beitrag entscheidend, wenn sich die Prognosen auf eine große Anzahl von Artikel-Standort-Kombinationen beziehen.
Es verwandelt jedoch keine fehlerhaften Daten in zuverlässige Signale. Ein nicht identifizierter Datenbruch, eine falsch kodierte Werbeaktion oder ein instabiler Referenzrahmen bleiben ein Problem, unabhängig vom verwendeten Algorithmus. Maschinelles Lernen kann sogar die in den historischen Daten vorhandenen Verzerrungen noch effektiver erlernen.
Die Herausforderung liegt in der Verknüpfung von drei Ebenen: aufbereitete Daten, angepasste Modelle und fachliche Validierung. Die Automatisierung verarbeitet die laufenden Datenreihen, während Warnmeldungen die Aufmerksamkeit auf signifikante Abweichungen, Verhaltensänderungen und wichtige Referenzwerte lenken. Die Rolle des Menschen verlagert sich somit von der repetitiven Datenbearbeitung hin zur Analyse von Ausnahmen und Hypothesen.
Wie lässt sich die Verkaufshistorie in den Prozess der Bedarfsplanung integrieren?
Eine statistische Prognose ist nur dann von Nutzen, wenn sie in operative Entscheidungen einfließt. Mithilfe der Bedarfsplanung lässt sich eine Referenzprognose erstellen, diese mit den verfügbaren Informationen ergänzen, validieren und anschließend an die verschiedenen Stufen der Lieferkette weiterleiten.
Der Prozess muss einem gemeinsam festgelegten Zeitplan folgen, der ein Extraktionsdatum, einen Prognosehorizont, eine Aktualisierungshäufigkeit sowie klar definierte Validierungsregeln umfasst. Geschäftsbezogene Anpassungen müssen auf ein identifiziertes Ereignis reagieren, wie beispielsweise eine Werbeaktion, eine Produkteinführung oder eine Veränderung im Vertriebsnetz.
Durch den Vergleich der Genauigkeit der statistischen Prognose mit der der endgültigen Prognose lässt sich anschließend überprüfen, ob diese Anpassungen die Ergebnisse tatsächlich verbessern. Diese Analyse hilft dabei, die Informationen zu identifizieren, die einen Mehrwert bieten, und manuelle Korrekturen einzuschränken, deren Nutzen nicht nachgewiesen ist.
Nach der Validierung dient die Prognose als Grundlage für die Beschaffung, die logistischen Kapazitäten, den Transport und die Lagerbestandsziele. Die Abweichungen zwischen den prognostizierten und den tatsächlichen Mengen werden anschließend zur Anpassung der Prognosemodelle und -regeln herangezogen. Die historischen Daten dienen somit nicht nur als einfaches Archiv, sondern tragen zur kontinuierlichen Verbesserung des Prozesses bei.
Welche Dashboards sollten eingerichtet werden?
Ein nützliches Dashboard stellt nicht einfach alle verfügbaren Kennzahlen nebeneinander dar. Es muss es ermöglichen, die Nachfrage zu verstehen, die Prognose zu überprüfen und auf die betrieblichen Auswirkungen zu reagieren.
Ein erster Überblick befasst sich mit der Datenqualität: Historische Abdeckung, fehlende Werte, erkannte Brüche, Anomalien und Aktualität der Quellen. Eine zweite Bewertung betrifft die Prognoseleistung: Fehler, Verzerrung, Genauigkeit nach Zeithorizont und Mehrwert der Anpassungen. Eine dritte Bewertung verknüpft die Prognose mit den Lagerbeständen: Verfügbarkeit, Ausfallrisiko, Überschuss, Umschlag und Abdeckung.
Die Visualisierung anhand von Ausnahmen ist effizienter als eine umfassende Überprüfung. Sie hebt Schwankungen im Bestandsniveau, anhaltende Fehler, Werbeaktionen mit erheblichen Auswirkungen oder Artikel hervor, deren Ungewissheit den Betrieb gefährdet. Die Schwellenwerte müssen den Wert und die Kritikalität des Produkts berücksichtigen; eine Abweichung von 20 Einheiten hat nicht bei allen Serien die gleiche Tragweite.
Fehler, die den Wert der historischen Daten mindern
Der erste Fehler besteht darin, die Verkaufszahlen als exakten Spiegel der Nachfrage zu betrachten. Der zweite besteht darin, Anomalien zu korrigieren, ohne deren Ursache zu ergründen. Eine automatische Verarbeitung kann dadurch nützliche geschäftliche Informationen ausblenden.
Ein weiterer häufiger Fehler besteht darin, Daten zu früh zu aggregieren. Ein landesweit stabiler Trend kann sehr unterschiedliche Entwicklungen in den einzelnen Filialen verschleiern. Die Arbeit mit zu detaillierten Zeitreihen, die nur wenige Verkäufe umfassen, kann jedoch ebenfalls die Zuverlässigkeit der Prognosen beeinträchtigen. Es gilt daher, die geeignete Analyseebene zu finden und die Konsistenz der Ergebnisse zwischen den verschiedenen Ebenen der Produkt-Standort-Hierarchie sicherzustellen.
Es ist zudem riskant, über einen längeren Zeitraum hinweg dieselbe Prognosemethode beizubehalten. Das Verhalten eines Referenzprodukts verändert sich im Laufe seines Lebenszyklus, seiner Vertriebsstruktur oder aufgrund des Wettbewerbsdrucks. Die Modelle müssen daher regelmäßig überprüft und angepasst werden.
Schließlich darf statistische Genauigkeit nicht zum Selbstzweck werden. Ein Modell kann zwar gute Ergebnisse liefern, sich jedoch aufgrund seines Rechenaufwands, seiner Instabilität oder seiner mangelnden Verständlichkeit nur schwer in die Praxis umsetzen lassen. Die relevanteste Methode ist nach wie vor diejenige, die operative Entscheidungen tatsächlich verbessert.
Historische Daten als Entscheidungsgrundlage nutzen
Das Sammeln von Daten über Jahre hinweg reicht nicht aus, um die Zuverlässigkeit der Prognosen zu gewährleisten. Werden Einbrüche als Nachfragerückgang interpretiert oder werden verkaufsfördernde Spitzen als normale Umsätze angesehen, wirken sich diese Fehler unmittelbar auf die Lagerbestände, die Beschaffung und die Verfügbarkeit der Produkte aus.
Der Wert der historischen Daten hängt daher von der Fähigkeit ab, zwischen den tatsächlich erzielten Umsätzen und der tatsächlichen Nachfrage zu unterscheiden, die beobachteten Schwankungen zu erklären und eine Methode anzuwenden, die dem Verhalten des jeweiligen Produkts angemessen ist. Sobald die Daten zuverlässig aufbereitet sind, lassen sich damit Trends, saisonale Schwankungen und werbebedingte Effekte erkennen, aber auch Unsicherheiten messen und verschiedene Szenarien miteinander vergleichen.
Automatisierung und Vorhersagemodelle erleichtern diese Arbeit bei steigenden Datenmengen. Sie ersetzen jedoch weder die Datenqualität noch die fachliche Validierung.
Eine aussagekräftige Verkaufshistorie zeigt nicht nur, was verkauft wurde. Sie hilft dabei, entgangene Umsätze zu verstehen, die zukünftige Nachfrage zu prognostizieren und fundiertere Entscheidungen in Bezug auf Lagerbestände und Beschaffung zu treffen.
FAQ – Verkaufshistorie
Wie lange muss der Zeitrahmen der historischen Daten sein, um eine Prognose zu erstellen?
Das hängt vom jeweiligen Produkt ab. Anhand der Verkaufszahlen eines Jahres lassen sich zwar häufig saisonale Schwankungen erkennen, doch reicht dies nicht immer aus, wenn die Verkaufszahlen sehr unregelmäßig sind. Bei einem neuen Produkt können die Verkaufszahlen ähnlicher Artikel dabei helfen, eine erste Prognose zu erstellen.
Wie lassen sich die Verkaufszahlen eines neuen Produkts ohne historische Daten prognostizieren?
Die Verkaufszahlen ähnlicher Produkte können als Ausgangspunkt dienen. Die Prognose kann anschließend um den Preis, den Einführungszeitraum und die geplanten Vertriebsmaßnahmen ergänzt und angepasst werden, sobald die ersten Verkaufszahlen vorliegen.
Sollten alle verfügbaren Umsatzdaten berücksichtigt werden?
Nicht unbedingt. Ältere Daten können an Aussagekraft verlieren, wenn sich das Sortiment, die Preise oder die Kaufgewohnheiten geändert haben. Der gewählte Zeitraum muss für die Situation, die man prognostizieren möchte, repräsentativ bleiben.
Wie oft sollten die Prognosen aktualisiert werden?
Die Häufigkeit hängt vom Verkaufsrhythmus und den zu treffenden Entscheidungen ab. Produkte mit hoher Umschlagshäufigkeit oder solche, für die Sonderaktionen angeboten werden, erfordern eine engmaschigere Überwachung als Artikel mit stabiler Nachfrage. Entscheidend ist, die Prognose früh genug zu aktualisieren, um rechtzeitig Maßnahmen zur Beschaffung ergreifen zu können.